Inhoudsopgave:
- Inleiding
- Wat zijn crawlfouten in Google Search Console?
- Waar vindt u crawlfouten in Google Search Console
- De meest voorkomende soorten crawlfouten
- Stappenplan om crawlfouten op te lossen
- Tools om crawlfouten sneller te diagnosticeren
- Crawlfouten voorkomen: best practices
- Slotgedachten
- Veelgestelde vragen
Google kan geen pagina ranken die het niet kan crawlen. Google moet uw webpagina begrijpen, crawlen en indexeren; anders kan het die niet ranken. Een crawlfout treedt op wanneer Googlebot een pagina op uw site probeert te bezoeken, maar op een probleem stuit, zoals een servercrash, een ontbrekende pagina, een kapotte omleiding of een blokkade via robots.txt. Crawlfouten kunnen ongemerkt de indexering blokkeren, het crawlbudget van uw site verspillen en u verkeer kosten dat had kunnen converteren.
Het goede nieuws is dat de meeste crawlfouten te verhelpen zijn. Met Google Search Console krijgt u duidelijke gegevens om crawlfouten te diagnosticeren en op te lossen. De tool levert gegevens via twee belangrijke rapporten: het rapport Pagina-indexering en het rapport Crawlstatistieken. Nu u de rapporten heeft, is de volgende uitdaging weten waar u in de rapporten naar fouten moet zoeken en welke acties u moet ondernemen zodra u een fout ziet.
Deze gids helpt u crawlfouten in Google Search Console te vinden, stelt per type maatregelen voor om ze op te lossen en deelt best practices om ze in de toekomst te voorkomen.
Laten we beginnen!
Belangrijkste inzichten:
- Crawlfouten treden op wanneer Googlebot een URL niet goed kan bereiken. Het kan stuiten op problemen zoals serverstoringen, ontbrekende pagina’s, geblokkeerde toegang of verwarrende signalen zoals soft 404’s.
- Google Search Console heeft hoofdzakelijk twee rapporten om crawlfouten op te sporen: het rapport Pagina-indexering onder het gedeelte Indexering en het rapport Crawlstatistieken onder het gedeelte Instellingen. Met de tool URL-inspectie kunt u problemen verder diagnosticeren.
- U hoeft niet elke crawlfout op te lossen. Het is essentieel om prioriteiten te stellen en u eerst te richten op waardevolle pagina’s, zoals de homepage, money pages en pagina’s met verkeer of backlinks.
- Verschillende crawlfouten vragen om verschillende oplossingen. U moet fouten zoals een 404, een 5xx-serverfout, een omleidingsprobleem en een robots.txt-blokkade elk op een andere manier aanpakken.
- Leid niet elke 404 om. Leid een verwijderde URL om als er een relevante vervanging bestaat; bewuste 404’s of 410’s kunnen passend zijn.
- Klik na het oplossen altijd op Oplossing valideren in het rapport Pagina-indexering en vraag indexering aan voor belangrijke URL’s. Geef Google de tijd om de betreffende URL’s opnieuw te crawlen.
- Regelmatige monitoring met wekelijkse controles, schone sitemaps en correcte omleidingen helpt voorkomen dat de meeste crawlfouten terugkomen.
- Een schoon crawlprofiel beschermt uw crawlbudget, verbetert de indexering en ondersteunt een betere organische zichtbaarheid.
Wat zijn crawlfouten in Google Search Console?
Crawlfouten in Google Search Console zijn problemen die ontstaan wanneer Googlebot een webpagina probeert te bezoeken, maar die niet goed kan bereiken of crawlen. In plaats van die pagina’s normaal op te halen, stuit het op problemen zoals serverstoringen, ontbrekende pagina’s, geblokkeerde toegang of verwarrende signalen zoals soft 404’s.
Dit is te vergelijken met een lezer die uw artikel leest om er een samenvatting van te maken. Als de eerste pagina van uw boek op slot zit of er pagina’s ontbreken, kan de lezer nooit goed begrijpen wat het werkelijk betekent. Op dezelfde manier blokkeert Google de indexering van uw pagina’s wanneer het geautomatiseerde systeem van Google ze door een van deze problemen niet kan begrijpen, waardoor ze onzichtbaar worden in de zoekresultaten.
Wat het betekent als het geautomatiseerde systeem van Google uw webpagina niet goed kan bereiken:
- Uw belangrijke pagina’s kunnen uit de zoekresultaten verdwijnen.
- Het crawlbudget wordt verspild aan kapotte of weinig waardevolle URL’s.
- Het kan uw belangrijkste landingspagina’s treffen, wat vervolgens gevolgen heeft voor uw rankings en organische verkeer.
De conclusie is eenvoudig: crawlfouten zijn de manier waarop Google u laat weten dat het uw pagina probeerde te bereiken, maar dat er iets misging. U moet deze fouten oplossen om ervoor te zorgen dat uw waardevolste pagina’s altijd geïndexeerd en zichtbaar zijn in Google.
Waar vindt u crawlfouten in Google Search Console
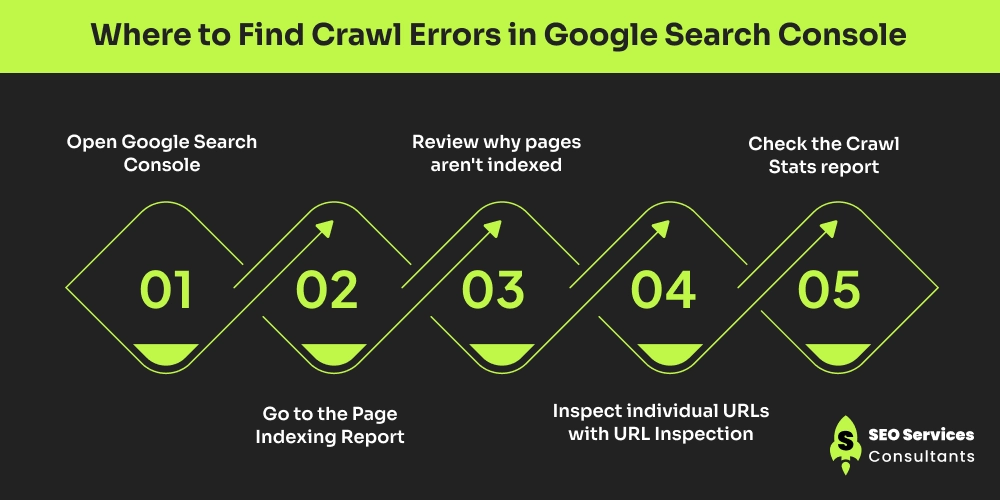
Google Search Console heeft geen apart rapport voor crawlfouten meer. De meeste crawlgerelateerde fouten verschijnen nu in deze twee rapporten: Pagina-indexering en Crawlstatistieken. Om afzonderlijke URL’s te diagnosticeren, kunt u vervolgens de tool URL-inspectie gebruiken.
Hier is een kort overzicht van hoe u ze kunt gebruiken:
Onderdeel van Search Console |
Doel |
|---|---|
| Pagina-indexering | Niet-geïndexeerde URL’s vinden en begrijpen waarom |
| Crawlstatistieken | Crawlen door Googlebot, responscodes en server- en verbindingsproblemen analyseren |
| URL-inspectie | Een specifieke URL onderzoeken en testen |
Stap 1: Open Google Search Console
- Log in bij Google Search Console.
- Selecteer in de vervolgkeuzelijst de juiste website of property die u wilt auditen.
- Beheert u meer dan één site, controleer dan of u naar de juiste kijkt voordat u conclusies trekt.
Stap 2: Ga naar het rapport Pagina-indexering
- Klik in het linkermenu op Indexering en selecteer vervolgens Pagina’s.
- Hier ziet u waarom bepaalde pagina’s niet zijn geïndexeerd, bijvoorbeeld door een blokkade, ‘niet gevonden’ of serverfouten. Al deze details vindt u onder “Waarom pagina’s niet worden geïndexeerd”.
Stap 3: Bekijk waarom pagina’s niet worden geïndexeerd
De redenen waarom pagina’s niet zijn geïndexeerd, vindt u onder het gedeelte “Waarom pagina’s niet worden geïndexeerd”. Veelvoorkomende crawlproblemen zijn onder meer:
- Serverfout (5xx)
- Niet gevonden (404)
- Soft 404
- Omleidingsfout
- Geblokkeerd door robots.txt
- Gecrawld - momenteel niet geïndexeerd (en andere verwante statussen)
U kunt op een reden klikken om de lijst met betrokken URL’s te zien. U kunt de lijst ook exporteren om die gemakkelijker te bekijken.
Stap 4: Inspecteer afzonderlijke URL’s met URL-inspectie
Om een specifieke pagina in detail te diagnosticeren, gebruikt u de tool URL-inspectie bovenaan Google Search Console. Plak gewoon de problematische URL en druk op Enter. Deze tool laat u zien:
- Of Google de pagina kon crawlen
- De geretourneerde HTTP-statuscode
- Of de pagina is geïndexeerd
- Eventuele blokkades (robots.txt, noindex enz.)
- De optie om de live-URL te testen en indexering aan te vragen
Stap 5: Bekijk het rapport Crawlstatistieken
Om sitebrede server- of beschikbaarheidsproblemen op te sporen die mogelijk niet duidelijk zichtbaar zijn in het rapport Pagina-indexering, kunt u het rapport Crawlstatistieken gebruiken.
Dit rapport geeft u een breder beeld van hoe Googlebot uw hele site crawlt. Let op:
- Beschikbaarheid van de host
- Responscodes (vooral 5xx-fouten en time-outs)
- Trends in crawlverzoeken
- Plotselinge pieken in fouten
Houd er rekening mee dat een lange lijst gemelde URL’s in Google Search Console niet altijd betekent dat uw site problemen heeft. Veel van die URL’s kunnen oude links, duplicaten of pagina’s zijn die u bewust heeft verwijderd. Mogelijk hoeven ze ook niet te worden opgelost.
De strategie moet zijn dat u zich, in plaats van elke fout na te jagen, richt op uw belangrijke pagina’s, zoals de homepage, dienstpagina’s of landingspagina’s met veel verkeer die er voor uw bedrijf meer toe doen.
De meest voorkomende soorten crawlfouten
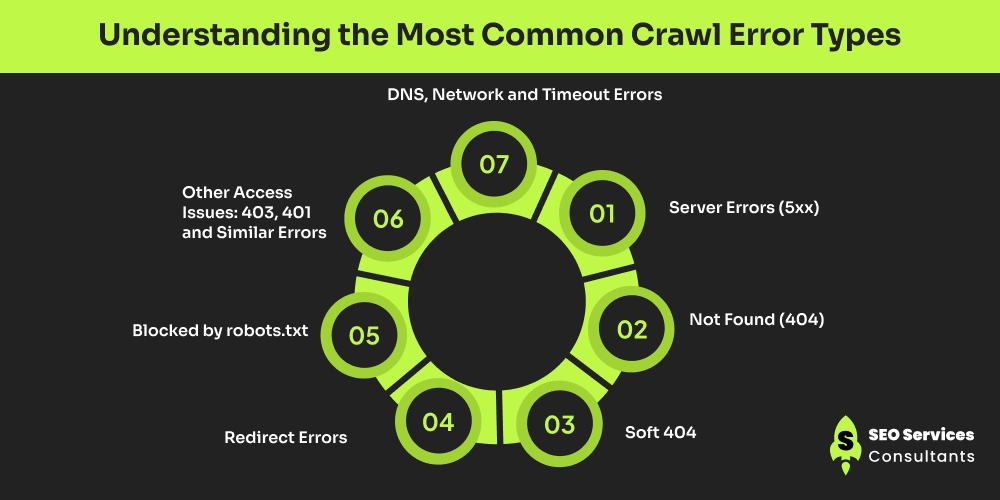
Niet alle crawlfouten zijn even ernstig. Het gaat om hun impact. Problemen die er direct voor zorgen dat uw belangrijke pagina’s niet in de zoekresultaten verschijnen, moeten met voorrang worden aangepakt. Sommige problemen zijn te verwachten of bewust en wijzen niet per se op een SEO-probleem. Als u de impact en betekenis van elk ervan begrijpt, weet u hoe serieus u ze moet nemen.
Hier is een kort overzicht van crawlfouten en wat ze betekenen, zodat u gericht actie kunt ondernemen.
Crawlfout |
Wat het betekent |
Prioriteit |
|---|---|---|
| 5xx-serverfout | De server kon het verzoek van Google niet afhandelen | Kritiek |
| 404 Niet gevonden | De URL bestaat niet | Gemiddeld |
| Soft 404 | Pagina lijkt te ontbreken of mager, maar retourneert 200 | Gemiddeld |
| Omleidingsfout | Omleiding is kapot, loopt in een lus of is excessief | Hoog |
| Geblokkeerd door robots.txt | Crawlen wordt geblokkeerd door robots.txt | Hoog |
| 403 Verboden | De server weigert het verzoek van Google | Hoog |
| 401 Niet geautoriseerd | De pagina vereist authenticatie | Hoog |
| DNS-fout | Google kan het domein niet omzetten | Kritiek |
| Time-out | De server reageert niet op tijd | Hoog |
1. Serverfouten (5xx)
- Dit zijn kritieke problemen die voorkomen dat Googlebot uw site kan bereiken.
- De server reageert niet. Dit kan komen door een 500 Internal Server Error, 502 Bad Gateway, 503 Service Unavailable of 504 Gateway Timeout.
- Deze fouten zijn cruciaal, omdat ze meerdere pagina’s tegelijk kunnen treffen en ertoe kunnen leiden dat Google het crawlen van uw hele website vertraagt.
2. Niet gevonden (404)
- Een 404-fout betekent dat Googlebot een pagina heeft opgevraagd die niet op uw server bestaat.
- Deze fout kan optreden als de pagina is verwijderd of de URL is gewijzigd.
- De impact van deze fout hangt af van het verkeer op die pagina. De impact is groot als de pagina verkeer of backlinks heeft.
- De impact is klein tot verwaarloosbaar als de pagina bewust is verwijderd en geen waarde heeft.
3. Soft 404
- Een soft 404-fout treedt op wanneer een pagina er voor Googlebot uitziet alsof die ontbreekt. De server retourneert een 200 OK-code, maar voor Google lijkt het alsof de pagina geen echte inhoud heeft.
- De impact kan gemiddeld tot groot zijn, omdat deze pagina’s crawlbudget kunnen verspillen en meestal niet worden geïndexeerd.
4. Omleidingsfouten
- Deze fout treedt op wanneer Google een omleiding volgde, maar op een probleem stuitte.
- Dit kan komen door een te lange omleidingsketen, een omleidingslus, een leeg doel of een doel dat een fout retourneert.
- Dit moet met hoge prioriteit worden aangepakt, omdat omleidingsproblemen kunnen voorkomen dat pagina’s worden gecrawld en tot verlies van linkwaarde kunnen leiden.
5. Geblokkeerd door robots.txt
- Deze fout treedt op wanneer uw robots.txt-bestand voorkomt dat Googlebot de pagina crawlt.
- De prioriteit kan gemiddeld tot hoog zijn, afhankelijk van welke pagina’s worden geblokkeerd.
- Het probleem ontstaat als belangrijke pagina’s, zoals dienst-, product-, categorie- of landingspagina’s, worden geblokkeerd.
6. Andere toegangsproblemen: 403, 401 en vergelijkbare fouten
Dit kunnen authenticatie- of toestemmingsfouten zijn die voorkomen dat Googlebot de content bereikt.
- 403 Verboden: de server begreep het verzoek, maar weigert toegang te verlenen.
- 401 Niet geautoriseerd: de pagina vereist authenticatie of geldige inloggegevens.
- Andere toegangsbeperkingen: beveiligingssystemen, firewalls, WAF’s of tools voor botbescherming kunnen legitieme crawlers de toegang tot openbare pagina’s ontzeggen.
De impact kan groot zijn als het openbare pagina’s betreft.
7. DNS-, netwerk- en time-outfouten
Deze fouten treden op wanneer Googlebot uw server niet kon bereiken door DNS-problemen, verbindingstime-outs of netwerkproblemen. Dit zijn de meest voorkomende oorzaken:
- Problemen met de DNS-configuratie
- Serveruitval
- Hosting- of infrastructuurproblemen
- Firewall- of beveiligingsbeperkingen
- Overbelasting van de server
- Trage reactietijden van de server
Deze problemen moeten met voorrang worden aangepakt, omdat ze van invloed kunnen zijn op het vermogen van Google om uw website te crawlen. Ze kunnen cruciaal zijn voor uw website.
Kortom: het doel moet niet zijn om het aantal fouten op nul te houden, maar om ervoor te zorgen dat Google de belangrijke pagina’s die u in de zoekresultaten wilt zien, betrouwbaar kan crawlen.
Stappenplan om crawlfouten op te lossen
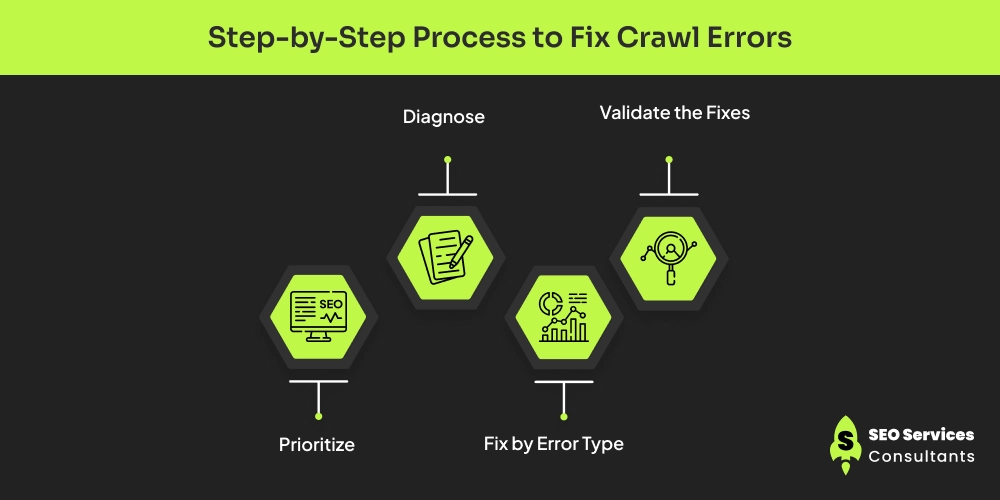
Crawlfouten oplossen wordt veel eenvoudiger als u een duidelijk proces volgt in plaats van willekeurig elke URL te repareren. Jaag niet op elk afzonderlijk probleem, maar geef prioriteit aan wat het belangrijkst is en pas voor elk type fout de juiste oplossing toe.
Hier is een praktische stapsgewijze aanpak die u kunt volgen:
1. Prioriteren
Niet elke fout vraagt direct aandacht. Begin met het prioriteren van pagina’s met de grootste zakelijke en SEO-waarde, zoals:
- Homepage
- Dienst- en productpagina’s
- Landingspagina’s met hoge conversie
- Pagina’s die organisch verkeer genereren
- URL’s met waardevolle backlinks
- Belangrijke categorie- of locatiepagina’s
Bewuste 404’s of URL’s met weinig waarde die niet geïndexeerd hoeven te worden, kunt u negeren. De onderstaande tabel toont welke problemen u op basis van prioriteit kunt aanpakken.
Prioriteit |
Aan te pakken problemen |
Waarom |
|---|---|---|
| Kritiek | 5xx-fouten, DNS-storingen, wijdverbreide time-outs | Google kan mogelijk grote delen van uw site niet bereiken |
| Hoog | Belangrijke pagina’s geblokkeerd door robots.txt, 403-fouten, omleidingsproblemen | Waardevolle pagina’s kunnen onbereikbaar worden voor Google |
| Gemiddeld | Belangrijke 404’s, soft 404’s, kapotte interne links | Kunnen de gebruikerservaring en SEO-signalen beïnvloeden |
| Laag | Bewuste 404’s, verouderde URL’s zonder waarde | Vereisen meestal geen actie |
2. Diagnosticeren
Zodra u weet welke URL’s niet worden gecrawld, is de volgende stap de hoofdoorzaak te achterhalen en precies vast te stellen waarom Google die pagina’s niet kan crawlen.
Hier is een kort overzicht van waar u op kunt letten om het probleem te vinden:
Wat te controleren |
Waar u op moet letten |
Tool |
|---|---|---|
| URL-status | Geïndexeerd, niet geïndexeerd, fout | URL-inspectie |
| HTTP-status | 200, 301, 404, 403, 5xx | URL-inspectie/servertools |
| Crawltoegang | Kan Google de URL bereiken? | URL-inspectie |
| robots.txt | Wordt crawlen geblokkeerd? | robots.txt |
| Omleidingen | Ketens, lussen, onjuiste bestemmingen | Omleidingschecker/crawler |
| Canonical | Juiste canonieke URL | URL-inspectie/broncode |
| Interne links | Kapotte of verouderde links | Screaming Frog/Sitebulb |
| Sitemap | Juiste URL’s opgenomen | Search Console |
| Server | Uitval, fouten, trage respons | Serverlogs/hosting |
| Beveiliging | WAF/firewall die bots blokkeert | Hosting-/beveiligingsplatform |
U kunt de onderstaande stappen volgen om de oorzaak van de crawlfout te diagnosticeren
a) Inspecteer de URL
Open URL-inspectie in Google Search Console en voer de betreffende URL in. U kunt de live-URL testen om de pagina te controleren zoals die nu bestaat. Let op signalen zoals:
- Of de URL toegankelijk is voor Google
- Informatie over de HTTP-respons
- Indexeringsstatus
- Canonieke URL
- Crawlinformatie
- Eventuele gemelde problemen met toegankelijkheid of indexering
b) Bekijk de crawlstatistieken
Controleer of het probleem meerdere URL’s treft. Om het probleem te vinden, kunt u letten op ongebruikelijke patronen in:
- Verzoeken van Googlebot
- Reactietijden van de server
- 5xx-responsen
- DNS-fouten
- Problemen met de serververbinding
Als er een plotselinge toename van serverfouten of een sterke verandering in de reactietijd is, kan het probleem eerder met de bredere infrastructuur samenhangen dan met afzonderlijke pagina’s.
c) Controleer de configuratie van uw server en website
Bij hardnekkige of moeilijk te diagnosticeren fouten kunt u het volgende onderzoeken:
- Foutlogboeken van server en applicatie
- Hostingconfiguratie
- robots.txt-bestand
- Omleidingsregels
- Firewall- of WAF-instellingen
- CMS-plug-ins en -thema’s
- Cacheconfiguratie
- DNS-configuratie
3. Oplossen per type fout
Zodra u de oorzaak heeft gediagnosticeerd, kunt u de volgende aanbevolen oplossingen toepassen:
Fout |
Veelvoorkomende oorzaken |
Hoe u dit oplost |
|---|---|---|
| 404 | Verwijderde pagina, gewijzigde URL, kapotte link | Pagina herstellen, omleiden of bewust verwijderd laten |
| 5xx | Overbelaste server, hostingprobleem, applicatiefout | Serverlogs, hosting, plug-ins en resources controleren |
| Soft 404 | Lege/magere pagina, ontbrekende content met status 200 | Nuttige content toevoegen of 404/410 retourneren |
| Omleidingsfout | Omleidingslus, keten, kapotte bestemming | URL rechtstreeks naar de eindbestemming laten verwijzen |
| Geblokkeerd door robots.txt | Onjuiste Disallow-regel | Blokkeringsregel verwijderen of aanpassen |
| 403 | Firewall, WAF, beveiligingsplug-in | Toegangs-/beveiligingsregels aanpassen |
| 401 | Authenticatie vereist | Authenticatie verwijderen als de pagina openbaar moet zijn |
| DNS-fout | Onjuiste DNS-records, domeinproblemen | DNS-configuratie corrigeren |
| Time-out | Trage server, overbelasting, netwerkproblemen | Servercapaciteit en reactietijd verbeteren |
Laten we elke oplossing in detail bespreken:
5xx-serverfouten oplossen
- Controleer in uw hostingdashboard op hoog CPU-, geheugen- of databasegebruik.
- Bekijk de foutlogboeken om de exacte oorzaak te vinden.
- Deactiveer tijdelijk recent toegevoegde plug-ins of thema’s.
- Wis de cache als u een cacheplug-in of cache op serverniveau gebruikt.
- Is de server tijdelijk overbelast, retourneer dan een 503- of 429-status zodat Google weet dat het later opnieuw moet proberen.
- Neem contact op met uw hostingprovider als het probleem aanhoudt.
- Test de URL’s na het oplossen opnieuw met de tool URL-inspectie.
Niet gevonden (404)
- Is de content verplaatst, dan kunt u een permanente 301-omleiding naar de nieuwe URL instellen.
- Is de content definitief verdwenen, dan kunt u een 410 Gone-status retourneren.
- Herstel interne links die naar de oude URL verwijzen.
- Verwijder de kapotte URL uit uw XML-sitemap.
- Laat bewuste 404’s met rust (geen actie nodig).
Soft 404
- Bestaat de pagina niet, dan kunt u een correcte 404- of 410-statuscode retourneren.
- Rankt de pagina, dan kunt u echte, nuttige content toevoegen zodat die niet langer op een foutpagina lijkt.
- Vermijd magere of lege pagina’s die een 200-statuscode retourneren.
- U kunt ook een noindex-tag toevoegen als u wilt dat de pagina live blijft maar buiten de index blijft.
Omleidingsfouten
- Maak omleidingsketens plat, zodat de oude URL met één 301-omleiding rechtstreeks naar de eindbestemming verwijst.
- Verwijder omleidingslussen (A → B → A).
- Zorg dat de uiteindelijke doelpagina goed laadt en een 200-status retourneert.
- Werk interne links en sitemaps bij zodat ze naar de uiteindelijke URL verwijzen.
Geblokkeerd door robots.txt
- Open uw robots.txt-bestand en verwijder per ongeluk toegevoegde Disallow-regels voor pagina’s die u geïndexeerd wilt hebben.
- Test het bijgewerkte bestand met de robots.txt-tester van Google.
- Wilt u een pagina alleen buiten de index houden (maar crawlen nog toestaan), gebruik dan een noindex-metatag of HTTP-header in plaats van een blokkade in robots.txt.
- Vraag na het bijwerken indexering aan voor belangrijke pagina’s.
DNS-, netwerk- en time-outfouten
- Controleer uw DNS-instellingen bij uw domeinregistrar.
- Controleer de regels van firewall, WAF of beveiligingsplug-in en zorg dat de IP-bereiken van Googlebot zijn toegestaan.
- Verbeter de reactietijd en totale capaciteit van de server.
- Houd het rapport Crawlstatistieken in de gaten om te bevestigen dat het probleem is opgelost.
Toegang verboden (403) of vergelijkbare problemen
- Controleer de instellingen van beveiligingsplug-ins, botbescherming of wachtwoordbeveiliging.
- Zorg dat openbare pagina’s geen inlog vereisen.
- Sta legitieme user-agents en IP-bereiken van Googlebot toe.
- Test opnieuw met de live-test van de tool URL-inspectie.
4. De oplossingen valideren
Een fout op uw website oplossen betekent niet automatisch dat Google het direct weet. U moet Google vragen uw pagina’s opnieuw te controleren, de voortgang volgen en die verifiëren.
De onderstaande tabel toont de stappen voor het valideren van de oplossingen. Richt u op het volgen van algemene trends en belangrijke URL’s in plaats van afzonderlijke URL’s.
Stap |
Tool / locatie |
Frequentie |
|---|---|---|
| Rapport Pagina-indexering bekijken | Indexering → Pagina’s | Wekelijks |
| Crawlstatistieken bekijken | Instellingen → Crawlstatistieken | Wekelijks / na oplossingen |
| Belangrijke URL’s inspecteren | Tool URL-inspectie | Na elke oplossing |
| Klik op “Oplossing valideren” | Binnen elke foutcategorie | Na het oplossen van een groep |
| Herstel van de indexering volgen | Grafiek Pagina-indexering | De volgende 2–4 weken |
Tools om crawlfouten sneller te diagnosticeren
Google Search Console is doorgaans uw startpunt om crawl- en indexeringsproblemen te vinden. Gebruik voor een diepere diagnose, vooral bij grote websites, tools zoals een websitecrawler, backlinktools en serverlogs om context toe te voegen wanneer u dieper moet graven.
Tool |
Ideaal voor |
Wat u kunt controleren |
|---|---|---|
| Google Search Console | Algemene monitoring | Indexerings-, crawl- en URL-problemen |
| URL-inspectie | Afzonderlijke URL’s | Crawl-/indexeringsstatus en live-test |
| Crawlstatistieken | Server-/crawlgedrag | Activiteit van Googlebot, responsproblemen |
| Screaming Frog | Sitebreed crawlen | Kapotte links, omleidingen, statuscodes |
| Sitebulb | Technische SEO-audit | Crawl- en sitearchitectuurproblemen |
| Ahrefs | Backlinkanalyse | Links die naar kapotte URL’s verwijzen |
| Semrush | Site-audit | Technische problemen en kapotte pagina’s |
| Serverlogs | Geavanceerde diagnose | Verzoeken van Googlebot en serverresponsen |
Crawlfouten voorkomen: best practices
Een crawlfout oplossen is slechts één onderdeel van optimalisatie. U moet ook maatregelen nemen om te voorkomen dat deze fouten terugkeren. De onderstaande tabel geeft de best practices om uw site toegankelijk te houden voor Google en onnodige crawlproblemen te beperken.
Praktijk |
Waarom het ertoe doet |
|---|---|
| Correcte omleidingen gebruiken bij migraties | Omleidingsketens en -lussen vermijden |
| robots.txt schoon houden | Voorkomen dat belangrijke pagina’s per ongeluk worden geblokkeerd |
| Consistente canonical-tags behouden | Dubbele of tegenstrijdige signalen vermijden |
| Onnodige URL-parameters beheersen | Onnodig crawlen beperken |
| De gezondheid van de hosting bewaken | Uitval en serverfouten voorkomen |
| Regelmatig technische SEO-audits uitvoeren | Crawlproblemen vroeg opsporen |
Tot slot
Crawlfouten zijn niet zomaar technische storingen; ze bepalen hoe Google uw website bereikt, indexeert en rankt. Het goede nieuws is dat ze met een duidelijke werkwijze goed te beheersen zijn. Het draait erom te weten waar u moet kijken en wat prioriteit heeft. Volg deze eenvoudige stappen:
- Spoor de problemen op in de rapporten Pagina-indexering en Crawlstatistieken.
- Geef prioriteit aan de fouten die uw belangrijkste pagina’s treffen.
- Diagnosticeer met de tool URL-inspectie en andere ondersteunende gegevens.
- Los de hoofdoorzaak op afhankelijk van het type fout.
- Valideer de wijzigingen en volg de resultaten.
U beschermt uw crawlbudget door deze problemen regelmatig te controleren en kritieke problemen als eerste aan te pakken. Zorg er altijd voor dat uw waardevolle pagina’s geïndexeerd zijn, zodat Google de beste kans krijgt om ze te ranken. Een schoner crawlprofiel leidt tot betere indexering, sterkere zichtbaarheid en meer organisch verkeer.
Veelgestelde vragen
Wat zijn crawlfouten in Google Search Console?
Crawlfouten in Google Search Console zijn problemen die ontstaan wanneer Googlebot een webpagina probeert te bereiken, maar op een probleem stuit. Dit kunnen 404-fouten, 5xx-serverfouten, omleidingsproblemen, robots.txt-blokkades, 403-fouten en DNS- of time-outproblemen zijn. Door deze fouten kan het geautomatiseerde systeem van Google de betreffende pagina niet crawlen en beoordelen.
Hoe vind ik crawlfouten in Google Search Console?
U vindt crawlfouten en verwante problemen voornamelijk in twee rapporten: het rapport Pagina-indexering en het rapport Crawlstatistieken. U kunt ook de tool URL-inspectie gebruiken om afzonderlijke URL’s te onderzoeken.
Het is het beste om voorrang te geven aan fouten die uw belangrijkste pagina’s treffen, zoals de homepage of waardevolle dienstpagina’s.
Moet ik elke crawlfout oplossen?
Nee. Het is juist essentieel om prioriteiten te stellen en u eerst te richten op waardevolle pagina’s, zoals de homepage, money pages en pagina’s met verkeer of backlinks. Bewuste 404’s en URL’s met weinig waarde kunt u negeren.
Wat is het verschil tussen crawlfouten en indexeringsproblemen?
Crawlfouten ontstaan wanneer Googlebot een URL niet goed kan ophalen en geen toegang tot een pagina krijgt. Dit kunnen 5xx-serverfouten, 404’s, DNS-storingen of blokkades via robots.txt zijn.
Indexeringsproblemen ontstaan wanneer Googlebot de pagina crawlt, maar besluit die niet te indexeren. Dit kan komen door magere pagina’s of dubbele content of content met weinig waarde.
Moeten alle 404’s worden opgelost?
Nee. U hoeft niet alle 404-fouten op uw website op te lossen. U hoeft alleen 404’s op belangrijke pagina’s op te lossen, zoals uw product- of dienstpagina’s, of URL’s met backlinks. Voor bewuste 404’s van verwijderde content hoeft u niets te doen.
Hoe lang duurt het voordat Google een opgeloste pagina opnieuw crawlt?
Er is geen vaste termijn waarbinnen Google een pagina opnieuw crawlt. De tijdlijn hangt af van factoren zoals de website, de URL, crawlpatronen en de aard van de wijziging. Voor belangrijke pagina’s kunt u met de tool URL-inspectie indexering aanvragen, maar dat garandeert geen onmiddellijke crawl of indexering.
Waarom blijft Google verwijderde pagina’s crawlen?
Google kan verwijderde pagina’s blijven crawlen als het die URL’s ontdekt via interne links, sitemaps of externe backlinks. Ook als u een pagina verwijdert, kunnen die URL’s nog in sitemaps, interne links of externe backlinks staan. Google kan blijven proberen de pagina te crawlen totdat het consequent een 404/410 ziet en de URL niet meer in links of sitemaps aantreft. Verwijder ze uit sitemaps en herstel interne links om herhaaldelijk crawlen te stoppen.
Wat moet ik doen als crawlfouten steeds terugkomen op mijn website?
Hardnekkige crawlfouten wijzen meestal op diepere problemen, zoals een instabiele server, verkeerd geconfigureerde omleidingen of onjuiste robots.txt-regels. Laat de opzet van uw site en de hosting auditen.
Hoe lang duurt “Oplossing valideren” in Google Search Console?
Er is geen gegarandeerde validatietermijn. Het kan enkele dagen tot 2 à 3 weken duren. Google moet de betreffende URL’s opnieuw crawlen en controleren of het onderliggende probleem is opgelost. Afhankelijk van het aantal URL’s en het type probleem kan validatie tijd kosten. U kunt het betreffende Search Console-rapport blijven volgen terwijl Google de wijzigingen verwerkt. Voor prioritaire pagina’s kunt u naar de URL-inspectietool gaan en indexering aanvragen om het opnieuw crawlen te versnellen.
Is ‘Gecrawld, momenteel niet geïndexeerd’ een crawlfout?
Niet precies. Het is eerder een indexeringsfout. Het betekent dat Google de pagina met succes heeft gecrawld, maar ervoor heeft gekozen deze niet te indexeren. Dit komt vaak door dunne content, duplicatie of lage waarde. Het is een indexeringsbeslissing, geen echte crawlfout.
Kunnen crawlfouten mijn rankings direct schaden?
Ja. Crawlfouten kunnen uw rankings direct beïnvloeden. Als belangrijke pagina’s niet worden gecrawld of geïndexeerd, verschijnen ze niet in de zoekresultaten. Frequente serverfouten kunnen er ook toe leiden dat Google de crawlsnelheid van uw site verlaagt.
Waar vind ik crawlfouten nu in Google Search Console?
Google Search Console biedt het oude, aparte rapport ‘Crawlfouten’ niet meer. De meeste crawlgerelateerde problemen zijn nu te vinden in twee rapporten: het rapport Pagina-indexering onder het onderdeel Indexering en het rapport Crawlstatistieken onder het onderdeel Instellingen.