

Als uw goed onderzochte blogs na weken of maanden nog niet zijn geïndexeerd, kan het voelen alsof weken hard werk spoorloos verdwijnen. En het kan iedereen overkomen, hoe ervaren of gezaghebbend uw merk ook is.
Dat komt doordat er geen enkele reden is waarom pagina’s of blogs niet worden geïndexeerd. Van dunne content en overlap tot onjuiste canonical-tags en crawlproblemen: verschillende factoren kunnen voorkomen dat Google uw content aan de index toevoegt.
Het verrassende deel! Soms is er helemaal geen technisch probleem – Google heeft gewoon niet genoeg reden gevonden om uw blog te indexeren.
Google heeft nooit gezegd dat het elke ingediende pagina zal indexeren; er is simpelweg geen garantie. Dus in plaats van Google herhaaldelijk te vragen uw pagina te indexeren, moet u begrijpen wat indexering werkelijk tegenhoudt.
In deze gids bespreken we:
- De meest voorkomende oorzaken waarom uw blogs niet worden geïndexeerd
- Hoe u specifieke problemen met uw blogs kunt vinden en oplossen
- Hoe u niet-indexering in de toekomst voorkomt
Laten we beginnen.
Controleer of Google uw blog echt heeft geïndexeerd
Het is makkelijk om een indexeringsprobleem te verwarren met een rankingprobleem, vooral wanneer een nieuw gepubliceerde blog niet verschijnt voor het doelzoekwoord. Controleer dus eerst of uw blog echt niet is geïndexeerd voordat u naar een oorzaak zoekt.
Zo doet u dat eenvoudig:
Zoek de exacte URL in Google
Begin met een eenvoudige Google-zoekopdracht met:
site:yourdomain.com/blog/post-url
Als de exacte pagina verschijnt, is die door Google geïndexeerd. Verschijnt de pagina niet, dan betekent dat nog niet dat ze niet is geïndexeerd. Toch is dit een belangrijke eerste controle, en u kunt de status bevestigen in Google Search Console.
Gebruik de inspectietool in Google Search Console (GSC)
Voer voor een betrouwbaardere controle de URL van de blog in de URL-inspectietool van Google Search Console in. Die laat zien of de URL momenteel op Google staat en kan onthullen waarom hij mogelijk niet is geïndexeerd.
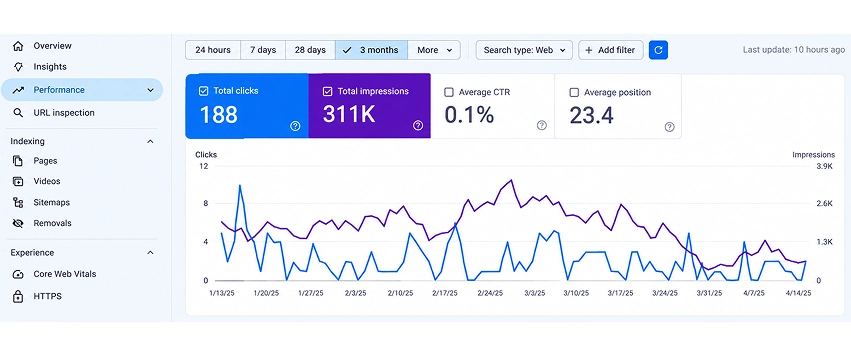
U kunt statussen zien zoals:
Statussen |
Betekenis |
|---|---|
| URL staat op Google | De pagina is geïndexeerd |
| URL staat niet op Google | Google heeft hem niet in de index opgenomen |
| Gecrawld - momenteel niet geïndexeerd | De pagina is gecrawld, maar Google heeft hem niet aan de index toegevoegd |
| Ontdekt - momenteel niet geïndexeerd | Google kent de URL, maar heeft hem nog niet gecrawld |
| Geblokkeerd door robots.txt | Crawlen is geblokkeerd voor de pagina |
| Uitgesloten door noindex | Een indexeringsinstructie voorkomt dat de pagina in de index wordt opgenomen |
| Duplicaat-/canonicalprobleem | Google beschouwt een andere URL als de voorkeursversie. |
Bekijk het rapport Pagina-indexering op patronen
Als meerdere blogposts van uw website niet zijn geïndexeerd, bekijk dan het rapport Pagina-indexering in Search Console. Dat helpt u te begrijpen of het probleem specifieke URL’s betreft of op een breder siteprobleem wijst.
Belangrijkste les: begin niet met het oplossen van technische SEO voordat u weet wat Search Console over de blog-URL zegt.
Is uw blog echt niet geïndexeerd of rankt hij gewoon niet?
Voordat u naar oplossingen voor het indexeringsprobleem zoekt, is het belangrijk vast te stellen dat indexering echt het probleem is. Dat een blogpost niet verschijnt voor uw doelzoekwoord, betekent niet per se dat Google hem niet heeft geïndexeerd. Hij kan al in de index staan, maar te laag ranken om zichtbaar te zijn.
Als de URL bijvoorbeeld verschijnt bij een site:-zoekopdracht maar niet wanneer u op uw doelzoekwoord zoekt, ligt het probleem eerder bij rankings of zichtbaarheid in zoekmachines.
Er kunnen meerdere vergelijkbare situaties zijn, uitgelegd in de tabel:
Situatie |
Wat het betekent |
|---|---|
| URL verschijnt niet in Google | Mogelijk indexeringsprobleem |
| URL verschijnt bij een site:-zoekopdracht, maar niet voor het doelzoekwoord | Waarschijnlijk een ranking-/zichtbaarheidsprobleem |
| URL rankt voorbij de eerste paar pagina’s | Rankingprobleem, geen indexeringsprobleem |
| URL was geïndexeerd en verdween later | Mogelijke deïndexering of gewijzigde indexeringsbeslissing |
| Sommige blogposts worden geïndexeerd, andere niet | Meestal een probleem op pagina-, content- of architectuurniveau, eerder dan een indexeringsprobleem van de hele site. |
Belangrijkste les: weten met welke situatie u te maken heeft is belangrijk, want de oplossing verschilt per geval.
Mogelijke redenen waarom Google uw blog niet indexeert
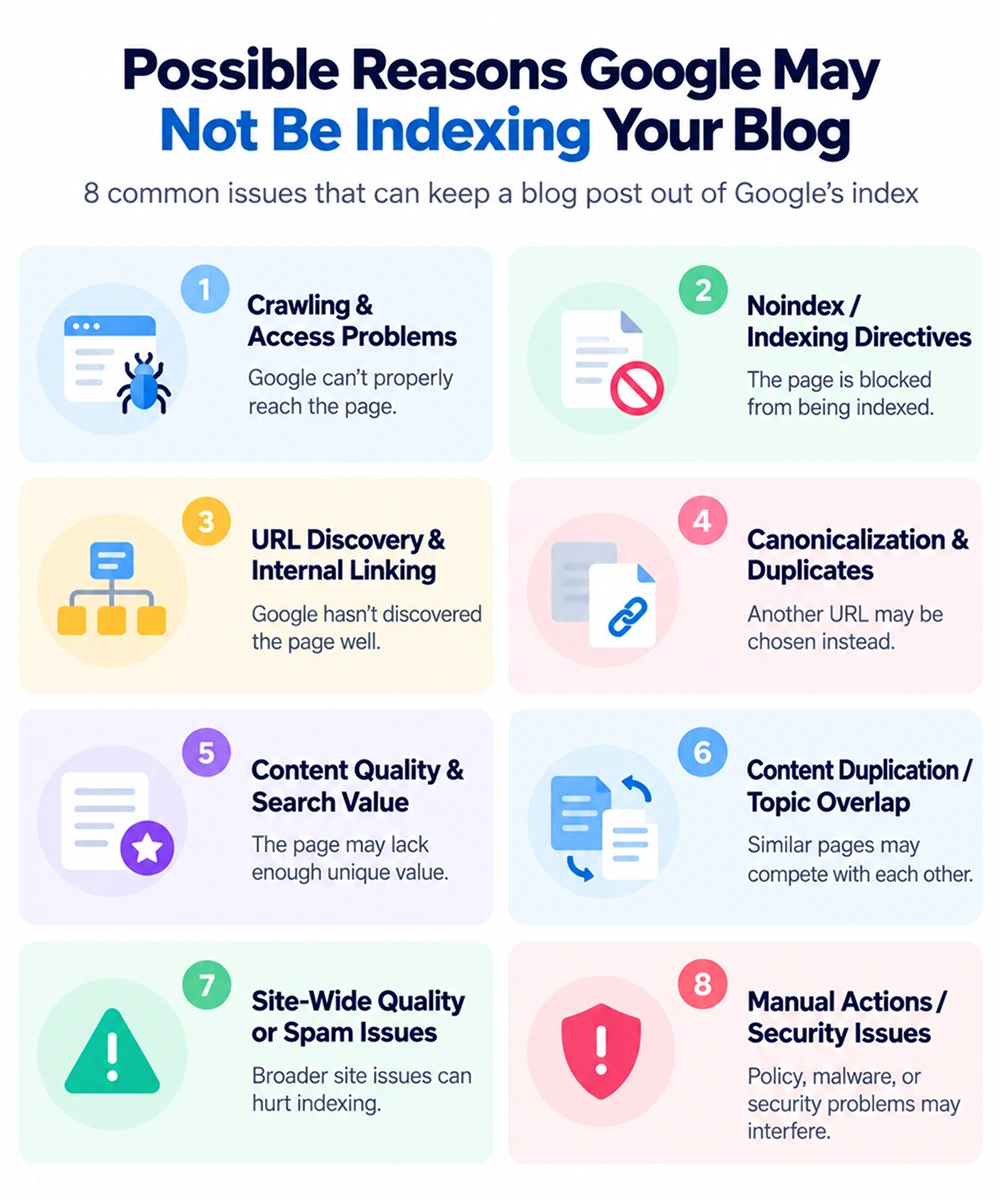
U publiceert misschien al uw blogposts correct, maar ze kunnen toch buiten de index van Google blijven. De meeste mensen denken dan dat slechte content de oorzaak is en gaan die meteen optimaliseren, soms zelfs meerdere keren.
Nou, dat klopt niet!
De reden kan van alles zijn, van technische toegang en indexeringssignalen tot andere problemen op siteniveau die ook kunnen voorkomen dat een pagina in de zoekresultaten verschijnt.
Als u de specifieke oorzaak kent, kunt u de juiste oplossing kiezen in plaats van onnodige wijzigingen door te voeren.
1. Crawl- en toegangsproblemen
Om uw pagina te kunnen indexeren, moet Google eerst de URL van uw blog kunnen bereiken en ophalen. Een robots.txt-regel kan het crawlen blokkeren, terwijl serverfouten, 4xx/5xx-responsen, firewallbeperkingen, wachtwoordbeveiliging of DNS- en hostingproblemen kunnen voorkomen dat Googlebot de URL bereikt. Zelfs tijdelijke storingen kunnen de ontdekking of verwerking vertragen.
Wat u moet controleren:
- URL-inspectie: test de live URL in Google Search Console om te zien of Google er toegang toe heeft.
- HTTP-status: controleer of de pagina een succesvolle respons geeft, meestal 200 OK.
- robots.txt: controleer of de URL niet onbedoeld wordt geblokkeerd.
- Crawlstatistieken: controleer in Search Console op terugkerende serverfouten of problemen met crawltoegang.
Los eerst de crawlproblemen op en vraag daarna zo nodig opnieuw indexering aan. Een verzoek kan een crawlblokkade of serverstoring niet omzeilen.
2. Een noindex of andere indexeringsinstructies verhinderen indexering
Soms kan Google uw blogpost bereiken, maar krijgt het expliciet de instructie die niet in de zoekresultaten op te nemen. Dit gebeurt meestal doordat er per ongeluk een noindex-instructie is toegevoegd.
Een noindex-instructie kan in de HTML van de pagina staan als metatag of in een HTTP-responsheader genaamd X-Robots-Tag. Ze kan ook ontstaan via zichtbaarheidsinstellingen in het CMS of de configuratie van een SEO-plugin.
noindex vs robots.txt – het verschil doet ertoe
robots.txt bepaalt of Google een URL mag crawlen, terwijl noindex Google vertelt een pagina niet in de zoekresultaten op te nemen. Als crawlen dus geblokkeerd is, kan Google de noindex-instructie op de pagina mogelijk niet zien.
Zo diagnosticeert en herstelt u het
- Open de betreffende URL in Google Search Console en bekijk de indexeringsdetails in URL-inspectie.
- Controleer de SEO-plugin of CMS-instellingen van de pagina en zorg dat zichtbaarheid voor zoekmachines is ingeschakeld.
- Controleer de paginabron op een noindex-metatag en de HTTP-responsheaders op X-Robots-Tag: noindex.
- Als de instructie per ongeluk is toegevoegd, verwijder die dan, test de URL opnieuw en vraag indexering aan.
3. Probleem met URL-ontdekking en interne links
Dit is een ander probleem dat optreedt wanneer Google de blog nog niet goed heeft ontdekt. U heeft de blog dan misschien wel succesvol gepubliceerd, maar Google weet niet dat de URL bestaat. Dit is een ontdekkingsprobleem.
Dit gebeurt vaak wanneer er geen interne links naar een post verwijzen, waardoor het een weespagina wordt. Ook wanneer belangrijke pagina’s diep verstopt zitten in categoriepagina’s, blogarchieven of ingewikkelde navigatie, kan dat ontdekkingsproblemen veroorzaken.
Als Google te veel links moet volgen om een blog te bereiken, kan het langer duren voordat de pagina wordt ontdekt. Hoewel een XML-sitemap Google kan helpen belangrijke URL’s te vinden, garandeert het indienen van een sitemap niet dat elke pagina gemakkelijk wordt gecrawld of geïndexeerd.
Zo diagnosticeert en herstelt u het
- Controleer in Google Search Console via URL-inspectie of Google de URL heeft ontdekt en wanneer die voor het laatst is gecrawld.
- Voeg interne links toe vanaf relevante, al ontdekte pagina’s, zoals de hoofdpagina van de blog, een categoriepagina of een nauw verwant artikel. Zorg dat deze links crawlbaar zijn.
- Herzie uw blogstructuur zodat belangrijke blogposts niet onder meerdere lagen verdwijnen of buiten de categorienavigatie vallen.
- Controleer uw XML-sitemap om te bevestigen dat de blog-URL erin staat en dat de sitemap geen verwerkingsfouten heeft.
Het is aan te raden een duidelijke sitenavigatie en crawlbare links te hebben, zodat Google uw pagina’s gemakkelijk ontdekt. Bovendien garandeert alleen een sitemap geen indexering.
4. Canonicalisatie- en duplicaatproblemen
Soms vindt Google uw blogpost, maar kiest het een andere URL om in de zoekresultaten te tonen. Dat gebeurt wanneer Google vindt dat twee of meer URL’s dezelfde of zeer vergelijkbare content bevatten en er één als hoofdversie selecteert. Dit heet canonicalisatie.
Het probleem kan ontstaan door:
- een onjuiste canonical-tag
- dubbele URL’s door trackingparameters
- HTTP- en HTTPS-versies
- versies met en zonder www, of
- content die op een andere website opnieuw is gepubliceerd.
Bijvoorbeeld: u wilt dat Google https://example.com/blog/seo-tips/ indexeert, maar de canonical-tag verwijst naar https://example.com/blog/seo-guide/. In dat geval kan Google in plaats daarvan de tweede URL kiezen.
Zo diagnosticeert en herstelt u het
Open GSC en ga naar de tool URL-inspectie om de door de gebruiker opgegeven canonical te vergelijken met de door Google gekozen canonical. Als ze verschillen, zoek dan uit waarom Google de andere URL verkiest.
- Corrigeer de canonical-tag zodat die naar de bedoelde pagina verwijst.
- Gebruik consistente URL’s in interne links en uw XML-sitemap.
- Redirect dubbele URL’s waar nodig en gebruik consequent HTTPS.
- Als u content opnieuw heeft gepubliceerd, ga dan na of de oorspronkelijke pagina duidelijk als voorkeursversie is aangemerkt.
Het is belangrijk te begrijpen dat een canonical-tag een signaal is, geen garantie. Google kan een andere URL kiezen als andere signalen aangeven dat die geschikter is.
5. Problemen met contentkwaliteit en zoekwaarde
Kom op, we weten het allemaal en toch maken we deze fout! Google houdt vaak geen rekening met blogposts met content van slechte kwaliteit, weinig zoekwaarde of technische problemen. Zulke pagina’s geven de crawler namelijk het signaal dat ze geen unieke waarde aan de zoekindex toevoegen.
Belangrijke redenen zijn:
- Dunne content: blogs met weinig content, zonder diepgang of die de vraag van de gebruiker niet goed beantwoorden. Google markeert zulke blogs als ‘Gecrawld - momenteel niet geïndexeerd’.
- AI-generatie van lage kwaliteit: content die met AI is gegenereerd zonder enige menselijke redactie, factcheck of persoonlijke inbreng voldoet niet aan de richtlijnen van Google voor nuttige content.
- Slechte leesbaarheid en structuur: als uw blog een kapotte opmaak, veel grammaticafouten of geen goede kopstructuur heeft, vinden gebruikers en crawlers hem minder snel waardevol.
Andere tekortkomingen die uw content minder waardevol maken:
- Algemene informatie
- Oppervlakkige antwoorden
- Overmatige opvulling
- Weinig of geen originele inzichten
- Gericht op zoekmachines, niet op gebruikers.
Als iemand bijvoorbeeld zoekt hoe hij een indexeringsprobleem met een blog oplost, kan een artikel dat indexering alleen definieert zonder uit te leggen hoe het probleem te diagnosticeren of op te lossen, de lezer zonder antwoord laten.
Een van de beste manieren om te voorkomen dat uw content door Google (en gebruikers) wordt genegeerd, is elk artikel nuttig en specifiek voor de zoekvraag te maken. Het moet ook meer waarde bieden dan wat lezers elders al kunnen vinden.
Zo diagnosticeert en herstelt u het:
- Vergelijk uw artikel met de zoekresultaten: beantwoordt het de hoofdvraag volledig, of herhaalt het informatie die lezers overal kunnen vinden?
- Voeg echte waarde toe: neem praktische stappen, relevante voorbeelden, originele inzichten of betrouwbare bronnen op waar ze het antwoord verbeteren.
- Verwijder opvulling: schrap herhalende inleidingen en secties die lezers niet helpen hun problemen op te lossen.
- Bekijk het doel van de pagina: zorg dat die een echte behoefte van het publiek vervult en niet alleen bestaat om op een zoekwoord te mikken. Voor Google telt content die voor mensen is gemaakt.
6. Contentduplicatie en overlappende onderwerpen
Als uw blog meerdere artikelen of pagina’s heeft die in wezen op dezelfde behoefte inspelen, kan Google moeite hebben te bepalen welke pagina het beste resultaat is. Dit gebeurt vaak wanneer u herhaalde varianten van één onderwerp publiceert of één onderwerp over meerdere artikelen verdeelt zonder elk artikel een eigen doel te geven.
Deze pagina’s kunnen concurreren om dezelfde zoekopdrachten, en sommige blijven mogelijk ongeïndexeerd. U publiceert bijvoorbeeld afzonderlijke artikelen met de titels ‘Waarom wordt mijn blog niet geïndexeerd?’ en ‘Redenen waarom Google uw blog niet indexeert’, terwijl beide vrijwel dezelfde problemen en oplossingen behandelen.
De oplossing is niet altijd content verwijderen. Bekijk de overlappende pagina’s en kies de beste aanpak:
- Samenvoegen: combineer nuttige informatie in één sterker artikel.
- Redirecten: stuur overbodige URL’s waar passend door naar de meest relevante pagina.
- Verbeteren: maak van één definitieve pagina de meest uitgebreide bron.
- Onderscheiden: behoud beide pagina’s als ze duidelijk verschillende zoekintenties bedienen.
Controleer echter, voordat u URL’s gaat wijzigen, hun verkeer, backlinks en huidige rankings om onnodig waardeverlies te voorkomen.
7. Uw site heeft bredere kwaliteits- of spamproblemen
Soms ligt het probleem niet bij één blogpost, maar bij het patroon op de hele website. Stel dat u elke week tientallen artikelen publiceert, maar geen enkele daarvan voegt informatie toe aan wat andere websites al bieden. Als uw site bovendien pagina’s vol keywords, ongerelateerde onderwerpen of backlinks bevat die alleen rankings manipuleren, kan dat leiden tot bredere kwaliteits- of spamproblemen.
Op grote schaal publiceren is niet automatisch een probleem; het gaat erom dat er pagina’s worden gemaakt zonder voldoende waarde voor lezers.
Hoe herkent u dit?
- Bekijk uw blog als geheel, niet alleen de URL’s die niet geïndexeerd zijn.
- Zoek naar grote groepen repetitieve artikelen, pagina’s die vooral zijn gemaakt om zoekverkeer aan te trekken, en praktijken die het spambeleid van Google schenden.
Hoe lost u dit op?
- Verbeter of consolideer zwakke pagina’s
- Verwijder manipulatieve tactieken
- Zorg ervoor dat nieuwe content inspeelt op een echte behoefte van uw doelgroep.
- Controleer Google Search Console ook op handmatige acties.
8. Uw website heeft een handmatige actie, beveiligings- of beleidsprobleem
Een blog kan uit Google Zoeken verdwijnen om redenen die niets met de afzonderlijke artikelen te maken hebben. Als iemand bijvoorbeeld uw website hackt en verborgen spampagina’s toevoegt, kan Google verdachte activiteit detecteren.
Malware of andere beveiligingsrisico’s kunnen ook invloed hebben op hoe uw site wordt weergegeven. In andere gevallen kan Google een handmatige actie opleggen wanneer een menselijke beoordelaar vaststelt dat de site het spambeleid schendt.
Hier kunt u dit onderzoeken:
- Handmatige acties: open GSC en selecteer Beveiliging en handmatige acties -> Handmatige acties. Controleer of Google een beleidsschending heeft gemeld.
- Beveiligingsproblemen: open Beveiliging en handmatige acties -> Beveiligingsproblemen om te zoeken naar gehackte content, malware of andere beveiligingsrisico’s.
Als u een probleem vindt, pak dan de onderliggende oorzaak aan, beveilig uw website en volg indien van toepassing de instructies van Google om een beoordeling aan te vragen. Ga er niet van uit dat elk indexeringsprobleem een echt probleem is; controleer eerst de feiten.
Hoe diagnosticeert u een niet-geïndexeerde blog in 10 minuten?
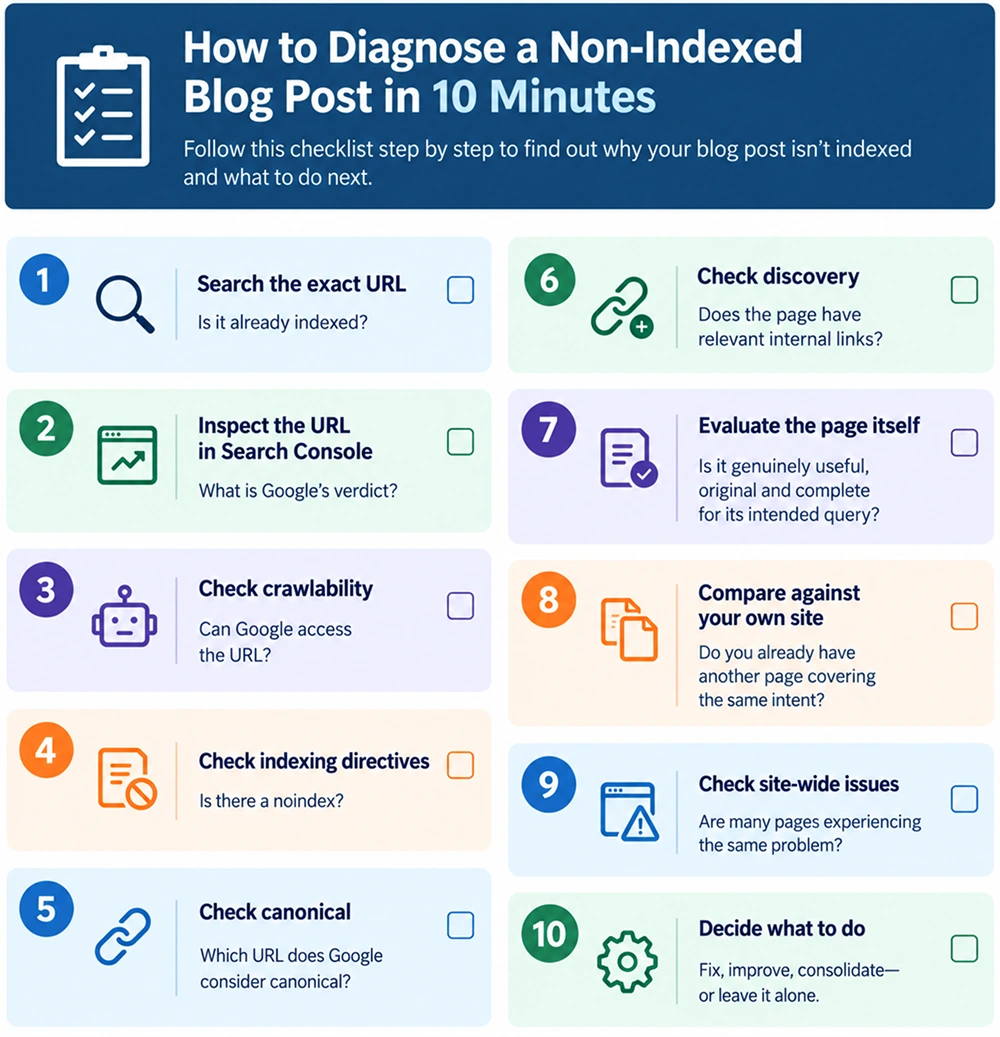
Gebruik deze snelle checklist om de mogelijke reden(en) te achterhalen waarom uw blog niet wordt geïndexeerd. Volg elke stap op volgorde om het probleem af te bakenen, onnodige aanpassingen te vermijden en te bepalen wat moet worden gecorrigeerd.
Wat moet u doen nadat u het probleem hebt opgelost?
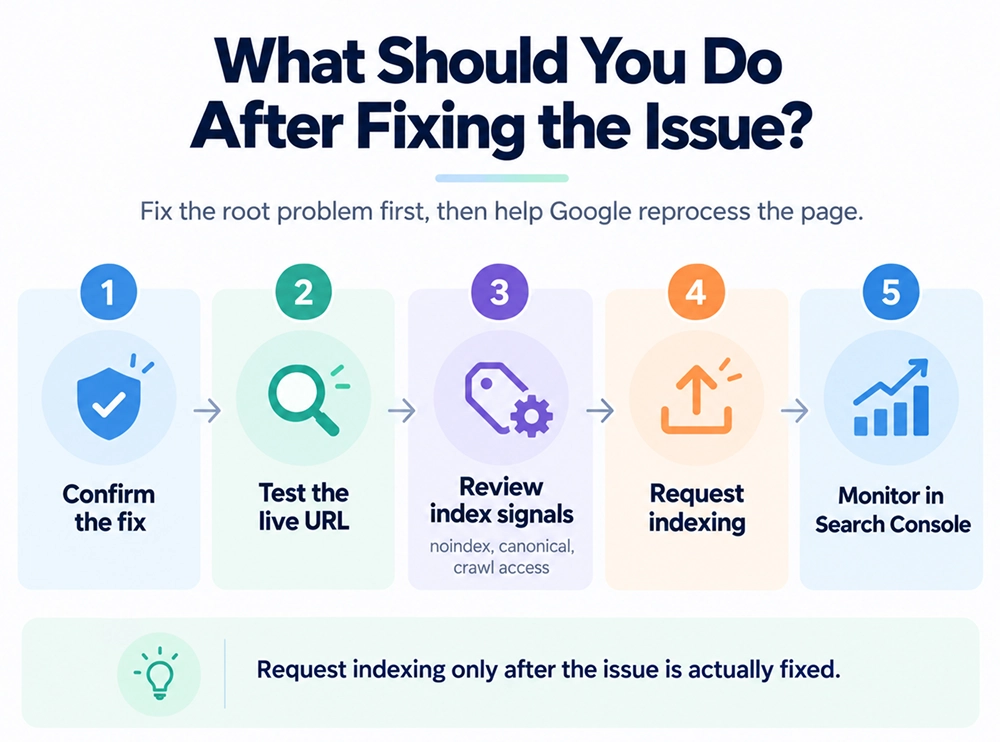
Zodra u hebt vastgesteld en bevestigd waarom Google uw blog niet indexeert, lost u het probleem op voordat u opnieuw om herindexering vraagt. Verwijder bijvoorbeeld een per ongeluk toegevoegde noindex-tag, verbeter content die weinig waarde biedt of corrigeer de canonieke tag.
Dit moet u vervolgens doen:
- Valideer de oplossing: zodra u het probleem hebt opgelost, gebruikt u de inspectietool van GSC om te controleren of de pagina toegankelijk is en of de indexeringsinstellingen kloppen. Hebt u een sitebreed probleem opgelost, gebruik dan de relevante validatieopties wanneer die beschikbaar zijn.
- Vraag indexering aan wanneer dat zinvol is: als de pagina klaar is, gebruik dan de inspectietool om herindexering aan te vragen. Let op: hiermee vraagt u Google de pagina opnieuw te crawlen, maar indexering is niet gegarandeerd.
- Geef Google de tijd om te crawlen: als uw werk klaar is, heb dan geduld. Laat Google en zijn bots hun werk doen; dat kan enkele dagen duren. Dien dezelfde URL niet herhaaldelijk in zonder verdere verbeteringen.
Conclusie
Als u herhaaldelijk indexeringsproblemen met uw blog hebt, ligt dat niet per se aan een technisch probleem. Soms zit het probleem in uw content, de manier waarop u uw pagina’s intern linkt, dubbele of canonieke pagina’s, of zelfs de manier waarop Google uw website beoordeelt.
Daarom is de eerste stap het controleren van de status van uw pagina in Google Search Console en begrijpen wat er werkelijk aan de hand is. Zodra u het probleem hebt gevonden, richt u zich op het oplossen ervan in plaats van herhaaldelijk om herindexering te vragen.
Onthoud: als u wilt dat uw blogs worden geïndexeerd, publiceer dan nuttige, originele content die uw doelgroep dient. Zorg er bovendien voor dat uw website technisch gezond is en eenvoudig te crawlen en te navigeren.
Indexeert Google uw pagina’s of blogs nog steeds niet, ook nadat u alles hebt geprobeerd? Neem dan contact op met ons SEO-bureau, SEO Services Consultants, en wij regelen het.
Veelgestelde vragen
1. Hoe lang duurt het voordat Google een blog indexeert?
Het kan enkele dagen tot meerdere weken duren voordat Google een blog indexeert, vooral als uw website vrij nieuw is. Dit hangt af van verschillende factoren, zoals de kwaliteit van de content, interne links, de technische structuur en gezondheid en de autoriteit van uw site.
2. Waarom krijgt mijn blog de status ‘Gecrawld - momenteel niet geïndexeerd’?
Als u deze status in Google Search Console ziet, betekent dit dat Google uw blog heeft gecrawld, maar nog niet in de index heeft opgenomen. Controleer de kwaliteit en originaliteit van de content, duplicatie en de canonieke instellingen om mogelijke problemen op te sporen.
3. Waarom ontdekt Google mijn pagina maar indexeert het deze niet?
Deze status betekent dat Google weet dat uw pagina bestaat, maar deze nog niet heeft gecrawld. Controleer de sitestructuur, interne links, de crawlbaarheid of Google de URL opnieuw heeft bezocht.
4. Kan het publiceren van te veel berichten mijn rankings schaden?
Nee, regelmatig content publiceren schaadt uw organische rankings niet. Als u echter grote hoeveelheden repetitieve content van lage kwaliteit produceert, kan dat de algehele kwaliteit van de site verzwakken en middelen verspillen zonder dat uw zichtbaarheid in zoekresultaten verbetert.
5. Waarom worden sommige blogs wel geïndexeerd en andere niet?
Google beoordeelt elke pagina afzonderlijk. Verschillen in contentkwaliteit, canonieke tags, interne links, toegankelijkheid en duplicatie kunnen verklaren waarom sommige blogs wel worden geïndexeerd en andere niet.
6. Hoe kan ik controleren of een blogpost is geïndexeerd?
Zoek in Google met site:uwdomein voor een snelle controle. Voer ter bevestiging de exacte URL in de URL-inspectietool van Google Search Console in om de werkelijke indexeringsstatus te bekijken.
Gurpreet Singh is marketingmanager bij SEO Services Consultants. In de loop der jaren heeft hij met bedrijven uit verschillende sectoren gewerkt en strategieën en benaderingen ontwikkeld die op hun behoeften zijn afgestemd.
De dagelijkse uitdagingen die hij in zijn werk tegenkomt, worden vaak de onderwerpen waarover hij schrijft. In zijn artikelen deelt hij wat hij leert uit zijn werk, onderzoek en observaties van actuele markttrends. Met zijn content wil hij lezers praktische, heldere en nuttige inzichten bieden.