

Wanneer Google een webpagina crawlt maar niet indexeert, verschijnt de pagina mogelijk niet in de zoekresultaten van Google. Dit probleem staat bekend als ‘Gecrawld - momenteel niet geïndexeerd’.
Er kunnen verschillende redenen zijn, zoals dubbele content, zwakke interne links, onjuiste canonical-tags en technische problemen.
Lees deze blog verder om te ontdekken waarom Google pagina’s vaak crawlt zonder ze te indexeren, hoe u het probleem in Google Search Console diagnosticeert en welke stappen u kunt nemen om de indexering van uw website te verbeteren.
Belangrijkste inzichten
- Google kan een webpagina bezoeken zonder hem in de zoekindex op te nemen.
- Dunne content of content van lage kwaliteit geeft Google minder redenen om een pagina te indexeren.
- Links van relevante pagina’s helpen Google uw websitestructuur te begrijpen en belangrijke URL’s te ontdekken.
- Onjuiste canonicals, serverfouten en renderingproblemen kunnen beïnvloeden hoe Google een pagina verwerkt.
- Probeer het probleem op te lossen voordat u een nieuwe crawl aanvraagt.
- Controleer of Google de pagina opnieuw heeft gecrawld en de indexeringsstatus heeft bijgewerkt, in plaats van aan te nemen dat het probleem is opgelost.
1. Wat betekent ‘Gecrawld maar niet geïndexeerd’ eigenlijk?
De meest voorkomende fout waar de meeste websites in Google Search Console mee te maken krijgen.
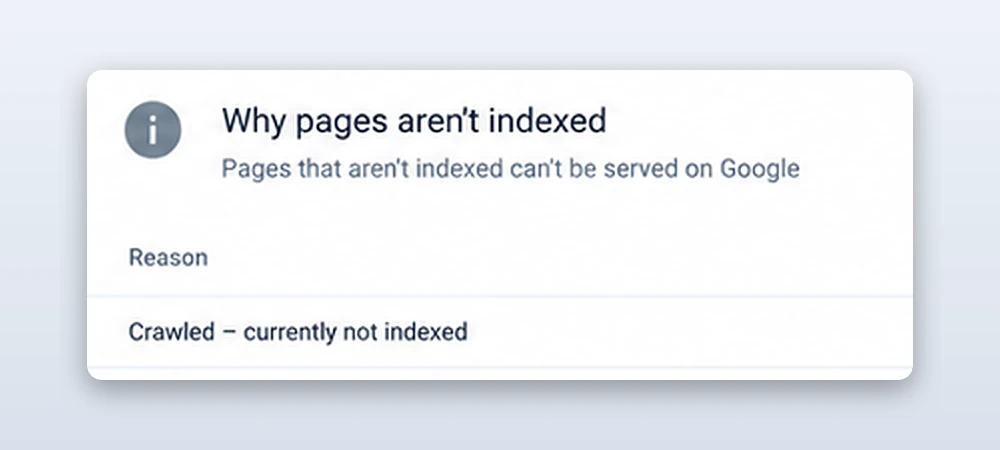
Wat betekent het echt?
Deze fout ontstaat meestal wanneer zoekmachinebots de URL ontdekken, opvragen en de content van uw pagina crawlen, maar hem niet aan de zoekindex van Google hebben toegevoegd.
Wanneer Googlebot een pagina crawlt, haalt hij informatie op zoals de HTML-content, links, metadata en andere toegankelijke bronnen. Na beoordeling van de pagina beslist hij vervolgens of hij die indexeert of niet.
Een eenvoudig voorbeeld: u publiceert een pagina ‘Technische SEO-diensten’ op uw website. Maar die verschijnt niet direct voor gebruikers in de zoekresultaten. Eerst bezoekt Googlebot de URL en leest hij de content.
Het kan echter zijn dat de pagina niet in de zoekresultaten verschijnt. In Google Search Console kan de URL de status ‘Gecrawld - momenteel niet geïndexeerd’ tonen.
Dit zijn mogelijke redenen waarom Google uw webpagina niet indexeert:
- Dunne content
- Aanzienlijke duplicatie
- Zwakke interne links
- Technische problemen
- Google’s beslissing om de pagina geen prioriteit te geven
Het is belangrijk te begrijpen dat deze status niet automatisch een straf of bewijs van slechte SEO is. Google kan de pagina later alsnog indexeren, en de juiste oplossing hangt af van waarom hij niet is geïndexeerd.
Wat is het verschil tussen crawlen en indexeren?
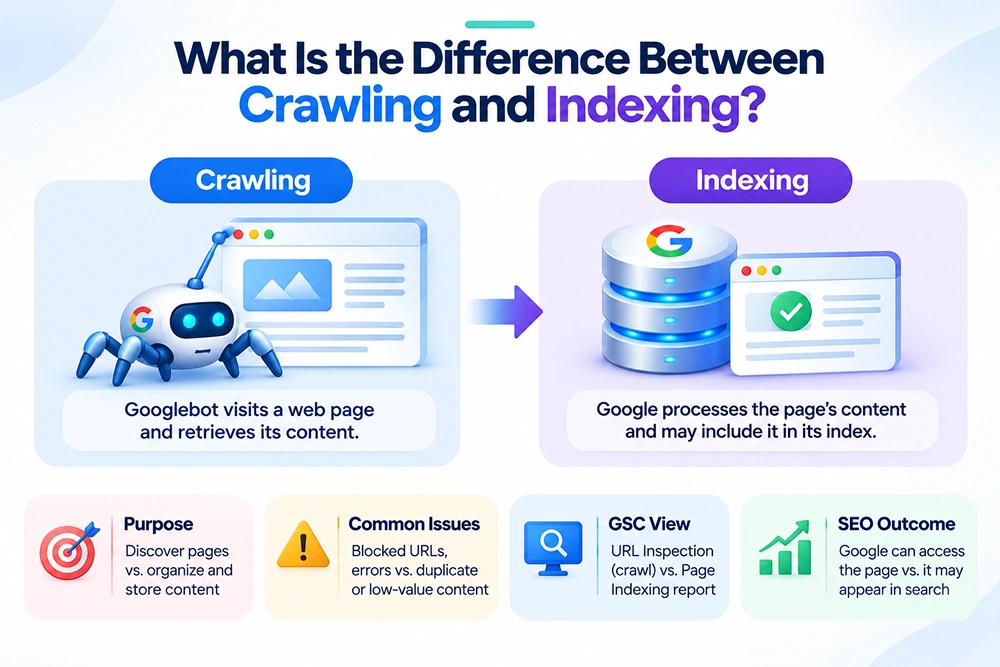
Crawlen en indexeren staan volledig los van elkaar.
Bij crawlen bezoeken zoekmachinebots een webpagina en halen ze de content op. Bij indexeren verwerkt Google de content en informatie van de pagina en beslist het of die in de index wordt opgenomen.
Hier leg ik de verschillen in detail uit
Belangrijkste punten |
Crawlen |
Indexering |
|---|---|---|
| Betekenis | Bij crawlen bezoekt Googlebot een pagina. | Hierbij verwerkt Google de pagina en kan het die in de index opnemen |
| Doel | Systematisch nieuwe of bijgewerkte webpagina’s ontdekken, doorzoeken en downloaden zodat de zoekmachine weet dat ze bestaan | Het doel van indexeren is webpagina-content te ordenen, analyseren en op te slaan in een enorme doorzoekbare database, zodat relevante resultaten binnen milliseconden kunnen worden opgehaald |
| Problemen | Geblokkeerde URL’s, serverfouten, ontdekkingsproblemen | Dubbele content, weinig waarde, canonieke selectie |
| Status in Google Search Console | Crawlactiviteit kan worden bekeken in URL-inspectie | Het rapport Pagina-indexering toont de indexeringsstatus |
| SEO-resultaat | Google kan de pagina bereiken | De pagina kan in aanmerking komen om in zoekresultaten te verschijnen |
Waarom belangrijke pagina’s worden gecrawld maar niet geïndexeerd
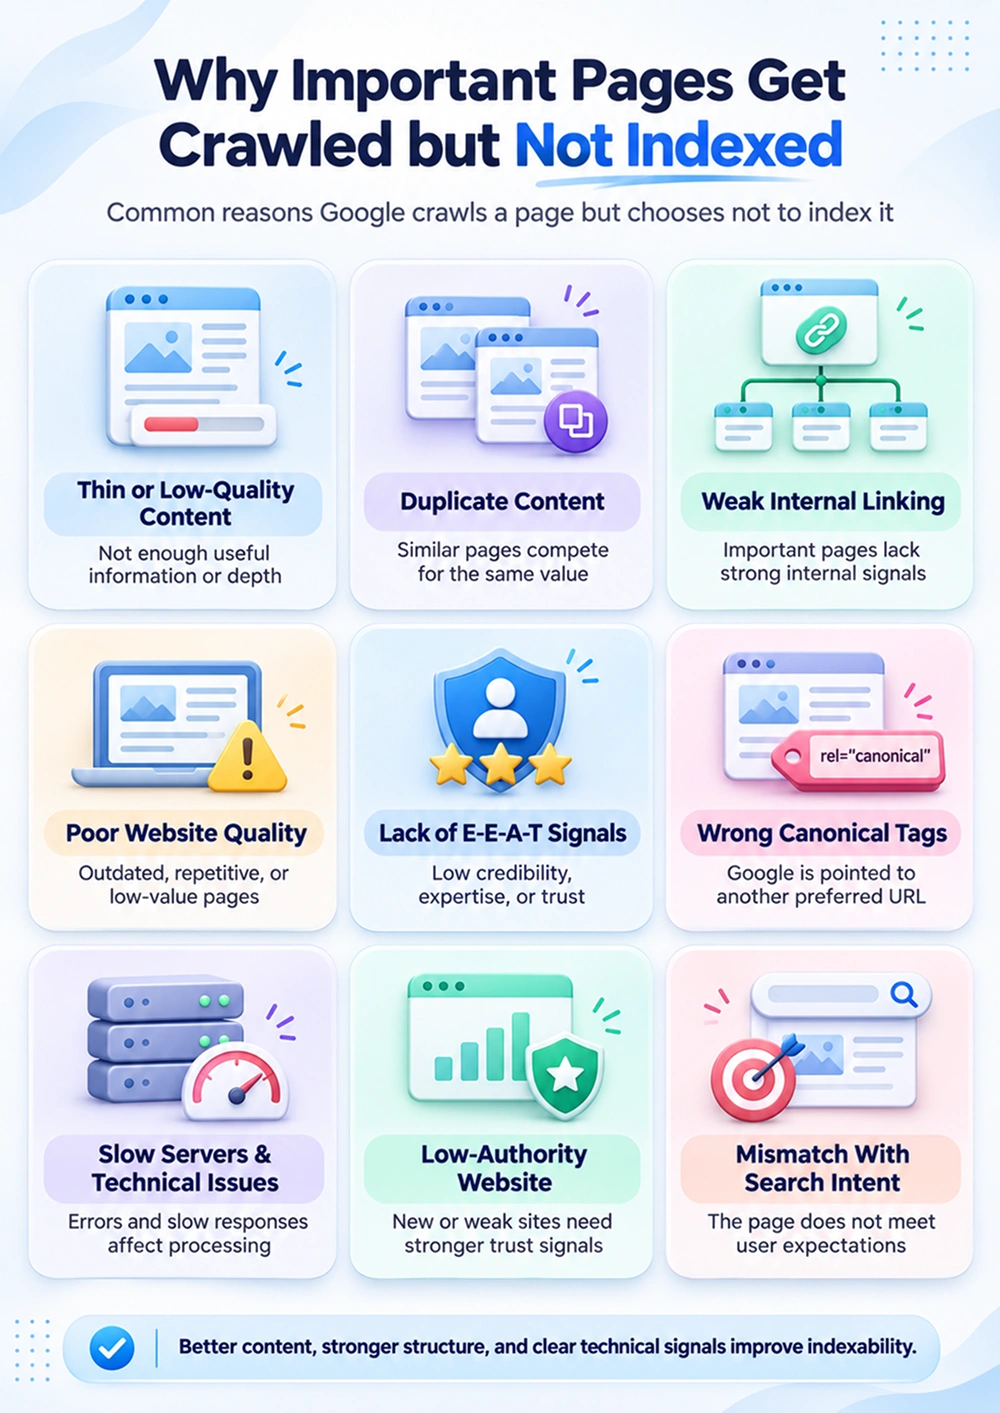
Er kunnen meerdere redenen zijn waarom uw webpagina niet wordt geïndexeerd. Het probleem kan samenhangen met contentkwaliteit, websitestructuur, technische configuratie enzovoort.
Dit zijn veelvoorkomende redenen:
3.1 Dunne content of content van lage kwaliteit
Dunne content verwijst naar pagina’s die weinig informatie of nutteloze details bieden of de vragen van gebruikers niet beantwoorden. Een pagina kan het doelzoekwoord bevatten en toch weinig waarde voor gebruikers hebben.
Voor Google is het belangrijk dat u zich richt op nuttige, relevante informatie.
Een SEO-bureau publiceert bijvoorbeeld een dienstpagina met de titel ‘Technische SEO-diensten’. De pagina bevat slechts drie korte alinea’s over technische SEO, zonder uit te leggen welke problemen het oplost, wat de dienst omvat of wat een klant kan verwachten.
Zo lost u het op:
- Leg het onderwerp voldoende gedetailleerd uit om aan de behoeften van de gebruiker te voldoen.
- Neem relevante informatie op over de dienst, het product of het onderwerp.
- Beantwoord belangrijke vragen die gebruikers kunnen hebben voordat ze een beslissing nemen.
- Voeg originele inzichten, praktische aanbevelingen of nuttige aanvullende informatie toe.
3.2 Dubbele content
Dubbele content ontstaat wanneer identieke of vergelijkbare content op meerdere URL’s beschikbaar is.
Dit kan Google in verwarring brengen, waardoor het één URL kiest om te indexeren in plaats van elke versie.
Stel dat u een online kledingwinkel heeft met deze URL’s:
- example.com/womens-dresses
- example.com/womens-dresses?color=black
- example.com/womens-dresses?sort=price
Als deze URL’s in wezen dezelfde categoriecontent tonen met alleen verschillen in filtering of sortering, kan Google sommige ervan onnodig vinden om te indexeren.
Een vergelijkbaar probleem kan zich voordoen wanneer een bedrijf aparte locatiepagina’s maakt met bijna identieke tekst en alleen de plaatsnaam verandert.
Zo lost u het op:
- Vergelijk de content van de getroffen URL’s.
- Bepaal of elke pagina een aparte zoekbehoefte vervult.
- Voeg pagina’s samen die geen betekenisvolle eigen waarde bieden.
- Gebruik passende canonical-tags om de voorkeursversie van dubbele of vergelijkbare pagina’s aan te geven.
- Zorg dat interne links en XML-sitemaps consequent naar de voorkeurs-URL’s verwijzen.
3.3 Zwakke interne links
Interne links verbinden pagina’s binnen dezelfde website. Ze helpen gebruikers door de site te navigeren en zoekmachines te ontdekken hoe pagina’s met elkaar samenhangen.
Wanneer een belangrijke pagina weinig of geen interne links heeft, kan het voor Google lastig zijn het belang ervan binnen de website te begrijpen.
Een SEO-bedrijf publiceert bijvoorbeeld een uitgebreide pagina over de kosten van e-commerce SEO. De pagina wordt echter niet gelinkt vanuit de hoofdnavigatie, de dienstenhub, relevante blogposts of andere belangrijke pagina’s.
Google kan de URL via een sitemap of externe link crawlen, maar de website geeft weinig interne signalen die het belang ervan onderstrepen.
Zo lost u het op:
- Link naar belangrijke pagina’s vanaf relevante dienst- of categoriepagina’s.
- Voeg contextuele links toe vanuit gerelateerde blogposts.
- Creëer logische topicclusters die gerelateerde content verbinden.
- Neem belangrijke pagina’s op in de juiste navigatie of hubpagina’s.
- Vermijd weespagina’s zonder betekenisvolle interne links.
3.4 Slechte websitekwaliteit
Ook de websitekwaliteit kan verhinderen dat Google pagina’s indexeert. Uw website kan herhaalde artikelen, verouderde informatie, landingspagina’s met weinig waarde of automatisch gegenereerde content met weinig originele waarde bevatten.
Uw website bevat bijvoorbeeld 500 blogposts, maar de meeste behandelen dezelfde onderwerpen. Google crawlt meerdere van deze pagina’s, maar indexeert slechts een deel ervan.
Zo lost u het op:
- Audit geïndexeerde en niet-geïndexeerde pagina’s op de hele website.
- Spoor herhaalde onderwerpen en overlappende zoekintenties op.
- Werk verouderde content bij waar betekenisvolle verbeteringen mogelijk zijn.
- Voeg artikelen samen die concurreren om dezelfde zoekvraag te beantwoorden.
- Verwijder of redirect pagina’s die geen nuttig doel meer dienen, waar dat gepast is.
- Verbeter de navigatie, de consistentie van pagina’s en de algehele gebruikerservaring.
3.5 Gebrek aan E-E-A-T-signalen
E-E-A-T staat voor Experience, Expertise, Authoritativeness en Trustworthiness (ervaring, expertise, autoriteit en betrouwbaarheid). Google beoordeelt uw contentkwaliteit op basis van deze richtlijnen, vooral bij onderwerpen waar nauwkeurigheid en vertrouwen zwaar wegen.
E-E-A-T is geen enkele technische rankingfactor die indexering garandeert. Content zonder geloofwaardigheid, echte expertise of onderbouwing kan gebruikers echter minder waarde bieden.
Uw website bevat bijvoorbeeld een blog over ‘serverfouten diagnosticeren’, maar zonder technische uitleg, bronnen, auteursinformatie of bewijs van praktijkervaring. De content herhaalt algemeen advies dat op veel andere websites te vinden is.
Lees voor meer informatie onze blog over waarom Google uw blog niet indexeert.
Zo verbetert u het:
- Publiceer nauwkeurige, goed onderbouwde informatie.
- Vermeld waar passend relevante kwalificaties of ervaring van de auteur.
- Verwijs naar betrouwbare bronnen voor feitelijke beweringen.
- Leg waar relevant uit hoe aanbevelingen zijn ontwikkeld of getest.
- Zorg voor duidelijke contactgegevens en transparante bedrijfsinformatie.
- Werk content bij wanneer de onderliggende informatie verandert.
3.6 Verkeerde canonical-tags
Een canonical-tag geeft aan welke URL als voorkeursversie moet worden behandeld bij dubbele of vergelijkbare pagina’s.
Wanneer een canonical-tag op de verkeerde URL is toegepast, kan Google besluiten dat de betreffende pagina een alternatieve versie is en een andere URL voor indexering kiezen.
Een bureau publiceert bijvoorbeeld een unieke pagina op:
example.com/technical-seo-services
De canonical-tag verwijst echter ten onrechte naar:
example.com/seo-services
Google kan de technische SEO-pagina dan zien als duplicaat of alternatief voor de algemene SEO-dienstenpagina.
Zo lost u het op:
- Controleer de door de gebruiker opgegeven canonical in Google Search Console.
- Vergelijk die met de door Google gekozen canonical.
- Zorg dat unieke pagina’s de juiste canonieke URL gebruiken, meestal een naar zichzelf verwijzende canonical.
- Controleer of canonieke doelpagina’s bereikbaar zijn en de juiste status teruggeven.
- Houd interne links en sitemaps consistent met de voorkeurs-URL.
3.7 Trage servers en technische problemen
Als een website voortdurend serverfouten of andere technische problemen heeft, kan Google moeite hebben de pagina’s consequent te crawlen en te verwerken.
Eén trage reactie zorgt er niet automatisch voor dat een pagina niet wordt geïndexeerd. Herhaalde storingen kunnen het crawlen echter beïnvloeden en de verwerking van belangrijke URL’s vertragen.
De hostingserver van uw website raakt bijvoorbeeld overbelast bij veel verkeer. Wanneer Googlebot een dienstpagina opvraagt, geeft de server een 503 Service Unavailable-respons. Vergelijkbare fouten treden op bij meerdere belangrijke pagina’s.
Zo lost u het op:
- Controleer serverresponscodes en hostinglogs.
- Onderzoek terugkerende 5xx-fouten en time-outs.
- Optimaliseer databasequery’s en zware scripts.
- Controleer caching en servercapaciteit.
- Zorg dat belangrijke bronnen betrouwbaar laden.
- Monitor de beschikbaarheid na technische wijzigingen.
3.8 Website met lage autoriteit
Google kan tijd nodig hebben om nieuwe websites met minder content en beperkte interne links te ontdekken en te beoordelen.
Een nieuw domein of een klein backlinkprofiel verhindert indexering echter niet automatisch. Nuttige pagina’s op nieuwe websites kunnen worden geïndexeerd, terwijl gevestigde websites ook niet-geïndexeerde pagina’s kunnen hebben.
U lanceert bijvoorbeeld 15 dienstpagina’s. Google crawlt er meerdere, maar in eerste instantie worden er maar een paar geïndexeerd.
Zo lost u het op:
- Zorg dat de homepage en de belangrijkste dienstpagina’s bereikbaar zijn.
- Dien een geldige XML-sitemap in.
- Link naar belangrijke pagina’s vanuit relevante navigatie en content.
- Publiceer nuttige, originele content voor duidelijk omschreven gebruikersbehoeften.
- Bouw legitieme brancherelaties op en verdien relevante vermeldingen.
- Monitor de indexering in plaats van dezelfde URL herhaaldelijk in te dienen.
3.9 Mismatch met zoekintentie
Zoekintentie vertelt wat gebruikers willen bereiken wanneer ze een zoekopdracht invoeren.
Een pagina kan relevant zijn voor een zoekwoord en toch niet voldoen aan de behoefte achter de zoekopdracht.
Als u bijvoorbeeld zoekt op ‘houten tafel online kopen’, wijst die zoekopdracht op een sterke koopintentie. U bezoekt een meubelsite met een artikel over soorten houten eettafels, maar zonder productoverzicht, prijzen of koopopties. Waarschijnlijk verlaat u de site.
Zo lost u het op:
- Bepaal of de zoekopdracht informatief, commercieel, transactioneel of navigationeel is.
- Bekijk welke soorten pagina’s verschijnen voor de doelzoekopdracht.
- Stem het contentformaat af op de behoeften van de gebruiker.
- Bied de informatie of actie die de bezoeker verwacht.
- Maak geen meerdere pagina’s voor dezelfde intentie zonder duidelijk onderscheid.
Zo controleert u het probleem in Google Search Console
Google Search Console helpt u problemen op te sporen die kunnen verhinderen dat pagina’s van uw website worden gecrawld, geïndexeerd of weergegeven in de zoekresultaten van Google.
Hier leg ik de stappen uit om het probleem te vinden en te begrijpen wat er moet worden opgelost.
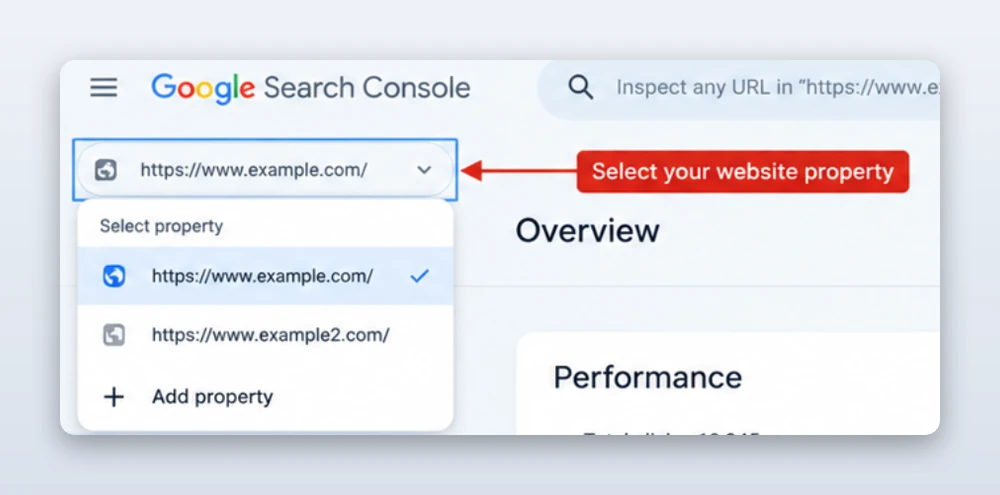
Stap 1: Open Google Search Console
Ga naar Google Search Console en selecteer uw websiteproperty.
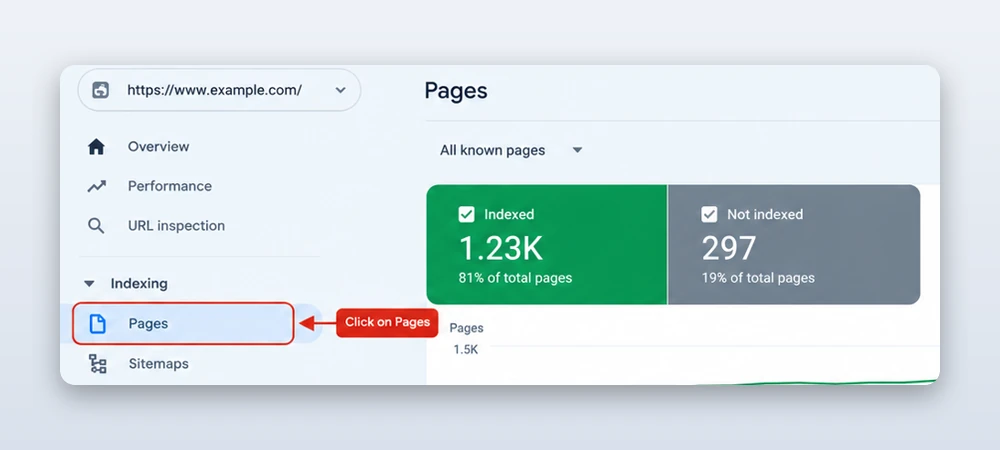
Stap 2: open het rapport Pagina’s
Klik daarna in het linkermenu op Indexering > Pagina’s. Dit rapport toont hoeveel websitepagina’s wel en niet door Google zijn geïndexeerd.
Stap 3: bepaal het indexeringsprobleem
Scrol omlaag naar het gedeelte Waarom pagina’s niet worden geïndexeerd. Hier toont Google Search Console verschillende redenen waarom pagina’s van de zoekresultaten worden uitgesloten, zoals:
- Gecrawld - momenteel niet geïndexeerd
- Ontdekt - momenteel niet geïndexeerd
- Niet gevonden (404)
- Pagina met omleiding
- Geblokkeerd door robots.txt
Klik op het betreffende probleem om de getroffen URL’s te bekijken en te onderzoeken welke pagina’s aandacht nodig hebben.
Stap 4: inspecteer de getroffen URL
Kopieer een URL uit het probleemrapport en plak deze in de zoekbalk van URL-inspectie bovenaan Google Search Console.
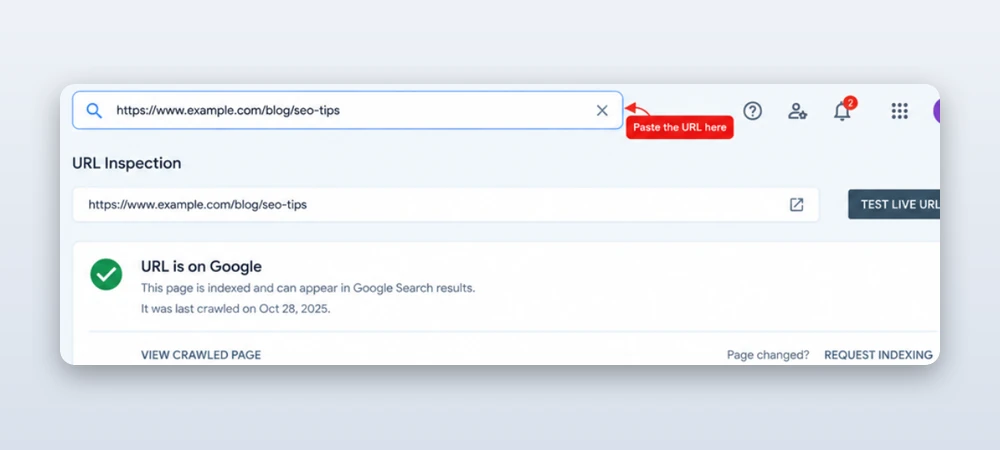
De tool toont informatie over de laatste crawl van Google, de indexeringsstatus en eventuele gevonden problemen.
Stap 5: test de live URL
Klik op Live-URL testen om te controleren of Google de pagina op het moment van testen kan bereiken. Bekijk de resultaten op crawlbeperkingen, serverfouten of renderingproblemen.
Onthoud dat een geslaagde live test niet garandeert dat Google de pagina indexeert.
Stap 6: los het probleem op en valideer de oplossing
Breng afhankelijk van het probleem de nodige wijzigingen aan. Herstel bijvoorbeeld kapotte URL’s, controleer robots.txt-beperkingen, verbeter dunne of dubbele content of los serverfouten op. Ga na het oplossen terug naar het betreffende rapport en klik op Oplossing valideren, als die optie beschikbaar is.
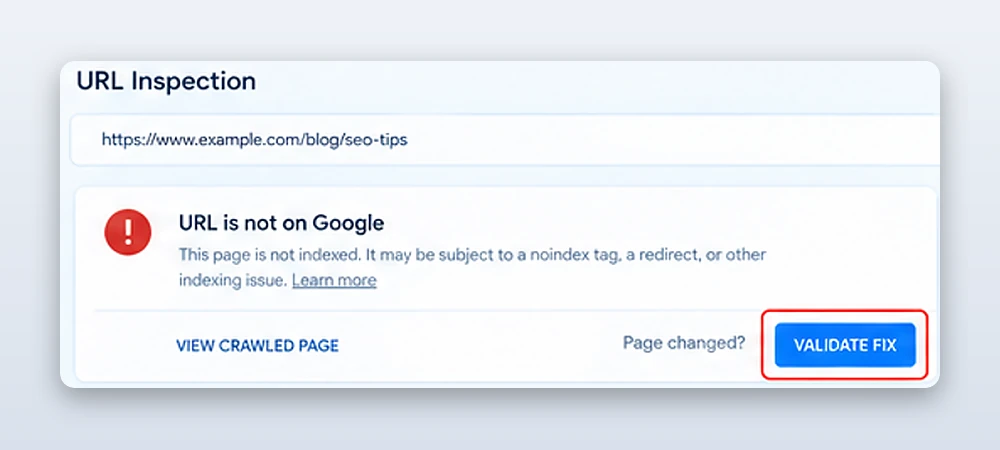
Google controleert daarna of het gemelde probleem is opgelost. Validatie kan even duren en indexering is niet gegarandeerd.
Hoelang duurt indexering?
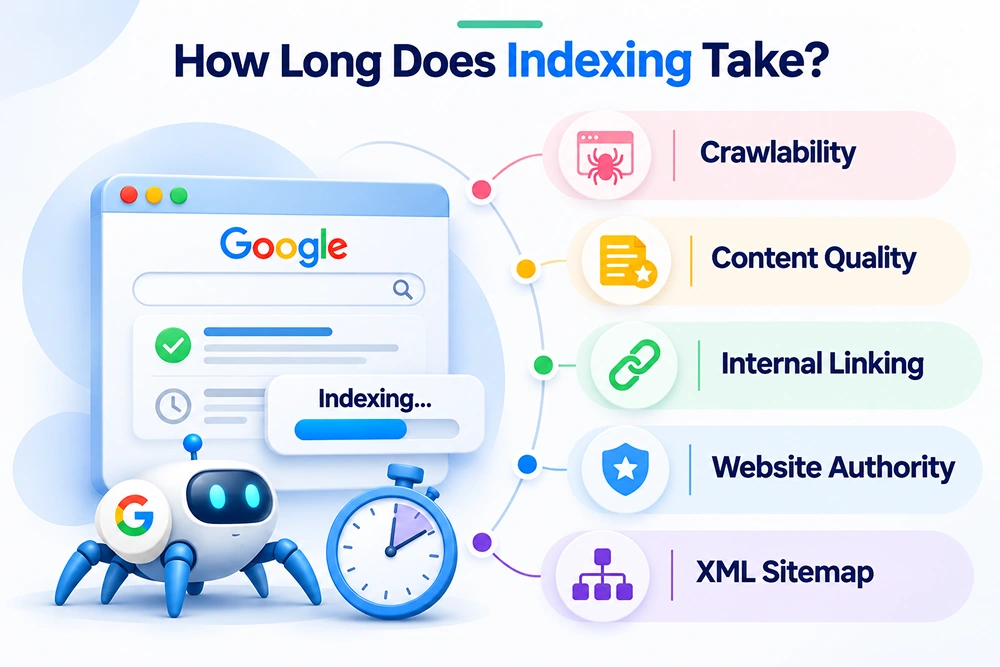
Indexering door Google duurt een paar weken, maar er is geen vaste termijn voor elke webpagina.
Sommige pagina’s worden snel geïndexeerd, terwijl andere er langer over doen.
Dit zijn enkele factoren die de duur beïnvloeden:
- Crawlbaarheid: Wanneer Googlebot een webpagina gemakkelijk vindt, heeft hij meer kans om die te crawlen en te beoordelen.
- Contentkwaliteit: Unieke, informatieve en relevante content helpt Google te bepalen of een pagina waardevol genoeg is voor de zoekindex. Bovendien gaat het niet om hoeveel content u publiceert, maar om de kwaliteit van de informatie die u biedt.
- Interne links: Links van relevante pagina’s helpen Google nieuwe URL’s te ontdekken en hun relatie met andere pagina’s op uw website te begrijpen.
- Website-autoriteit: De reputatie van een website kan meespelen in hoe Google de pagina’s ontdekt en crawlt.
- XML-sitemap: Het indienen van een sitemap helpt Google belangrijke URL’s te ontdekken, al garandeert het geen indexering.
Veelgemaakte fouten om te vermijden
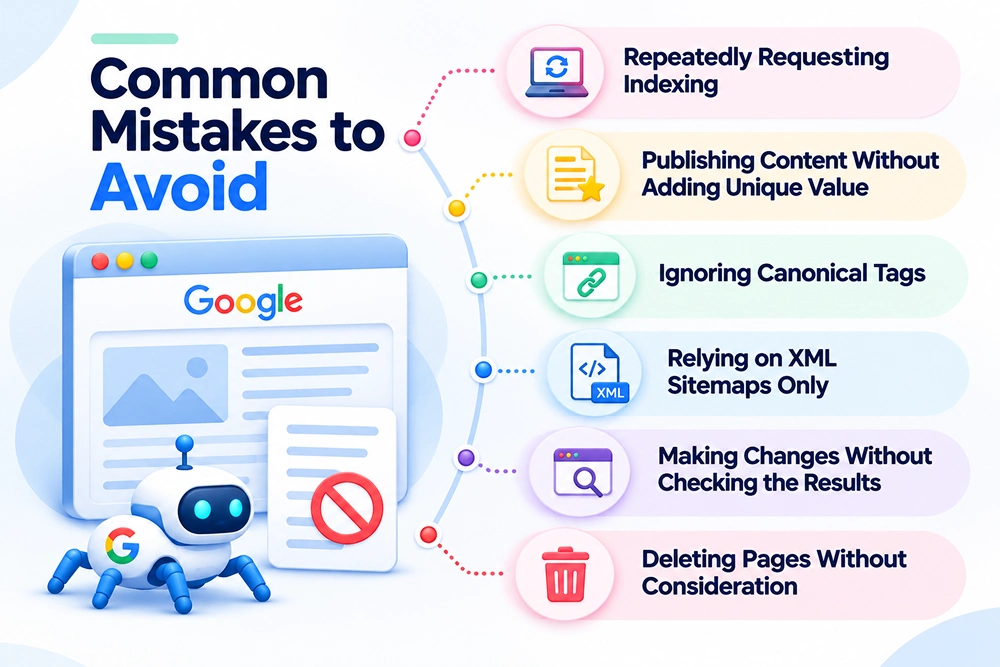
Dit gedeelte belicht veelgemaakte indexeringsfouten die de voortgang kunnen vertragen en legt uit hoe u ze vermijdt om de kans te vergroten dat Google uw website indexeert.
1. Herhaaldelijk indexering aanvragen
Herhaaldelijk indexering aanvragen in Google Search Console garandeert geen snellere indexering. Richt u liever op de reden waarom Google de pagina niet heeft geïndexeerd en probeer het probleem op te lossen voordat u opnieuw indexering aanvraagt.
2. Content publiceren zonder unieke waarde
Meer pagina’s publiceren betekent geen betere indexering. Als uw website herhaalde content of weinig informatieve pagina’s bevat, verbeter dan eerst de huidige content in plaats van nieuwe pagina’s te maken.
3. Canonical-tags negeren
Verkeerde canonical-tags kunnen aangeven dat Google een andere URL als hoofdversie van de pagina ziet. Controleer altijd de door de gebruiker opgegeven en de door Google gekozen canonicals om verschillen op te sporen.
4. Alleen op XML-sitemaps vertrouwen
Hoewel het indienen van een URL in een XML-sitemap Google kan helpen die te vinden, betekent het niet dat indexering zal volgen. Zorg dat belangrijke pagina’s gemakkelijk te vinden zijn, intern gelinkt zijn en nuttige content bevatten.
5. Wijzigingen doorvoeren zonder de resultaten te controleren
Ga er niet van uit dat een pagina is geïndexeerd nadat u een technisch of contentprobleem heeft opgelost. Volg de status in Google Search Console en gebruik de URL-inspectietool om te controleren of Google de pagina opnieuw heeft gecrawld.
6. Pagina’s zonder afweging verwijderen
Het is geen goed idee om alle niet-geïndexeerde pagina’s te verwijderen. Ga eerst na of uw pagina nuttig is, een specifieke zoekintentie vervult of verkeer oplevert. Verbeter de pagina’s vervolgens, voeg ze samen met andere of verwijder ze, afhankelijk van hun waarde.
Veelgestelde vragen
1. Waarom worden mijn belangrijke pagina’s gecrawld maar niet geïndexeerd?
Google kan een pagina crawlen zonder hem te indexeren als de content van lage kwaliteit is, andere pagina’s herhaalt, onvoldoende interne links heeft of geen uniek doel heeft. Ook technische problemen en canonical-problemen kunnen het indexeringsproces verstoren.
2. Hoe los ik de status ‘Gecrawld - momenteel niet geïndexeerd’ op?
Begin met het inspecteren van de getroffen URL in Google Search Console. Controleer de contentkwaliteit, canonical-tag, interne links, HTTP-status en rendering. Los eventuele crawlproblemen op die u vindt, vraag daarna zo nodig indexering aan en houd de status van de URL in de gaten.
3. Garandeert het aanvragen van indexering dat Google mijn pagina indexeert?
Nee. Een indexeringsverzoek betekent dat Google mogelijk probeert de pagina opnieuw te crawlen, maar Google beslist zelf of de pagina in de index wordt opgenomen.
4. Kunnen interne links Google helpen een pagina te indexeren?
Ja, belangrijke interne links kunnen Google helpen pagina’s te ontdekken en hun relatie met andere delen van uw website te begrijpen. Werken aan interne links garandeert echter geen indexering als de pagina andere problemen heeft.
5. Moet ik pagina’s verwijderen die niet worden geïndexeerd?
Niet per se. Als de pagina nuttig is, kunt u de content optimaliseren of technische problemen oplossen. Als de pagina een andere dupliceert of geen waarde meer biedt, overweeg dan samenvoegen, redirecten of verwijderen waar dat gepast is.
6. Wat is het verschil tussen ‘Gecrawld - momenteel niet geïndexeerd’ en ‘Ontdekt - momenteel niet geïndexeerd’?
Gecrawld - momenteel niet geïndexeerd: Google heeft de pagina gecrawld, maar niet in de index opgenomen.
Ontdekt - momenteel niet geïndexeerd: Google kent de URL, maar heeft hem nog niet gecrawld. Dit kan gebeuren wanneer Google het crawlen uitstelt, onder meer vanwege zorgen over de servercapaciteit.
Conclusie
Wanneer belangrijke pagina’s worden gecrawld maar niet geïndexeerd, is de oplossing niet simpelweg herhaaldelijk indexering aanvragen. U moet begrijpen waarom Google die pagina’s niet voor de zoekindex heeft gekozen.
Begin met het controleren van de getroffen URL’s in Google Search Console. Bekijk de contentkwaliteit, dubbele pagina’s, interne links, canonical-tags, serverresponsen en renderingproblemen. Breng daarna verbeteringen aan op basis van het werkelijke probleem.
Onthoud: crawlen garandeert geen indexering, en indexering garandeert geen rankings. Focus op het maken van nuttige pagina’s, een technisch toegankelijke website en het volgen van indexeringsveranderingen in de loop van de tijd.
Gurpreet Singh is marketingmanager bij SEO Services Consultants. In de loop der jaren heeft hij met bedrijven uit verschillende sectoren gewerkt en strategieën en benaderingen ontwikkeld die op hun behoeften zijn afgestemd.
De dagelijkse uitdagingen die hij in zijn werk tegenkomt, worden vaak de onderwerpen waarover hij schrijft. In zijn artikelen deelt hij wat hij leert uit zijn werk, onderzoek en observaties van actuele markttrends. Met zijn content wil hij lezers praktische, heldere en nuttige inzichten bieden.